US-DATAРазметка данных
Кабинет
Подготовим изображения, видео и каталоги для обучения AI-моделей — распознавание товаров, полочная аналитика, классификация, сегментация, OCR и визуальный поиск.
От тестовой выборки до готового датасета для production.
Рассчитать стоимость проекта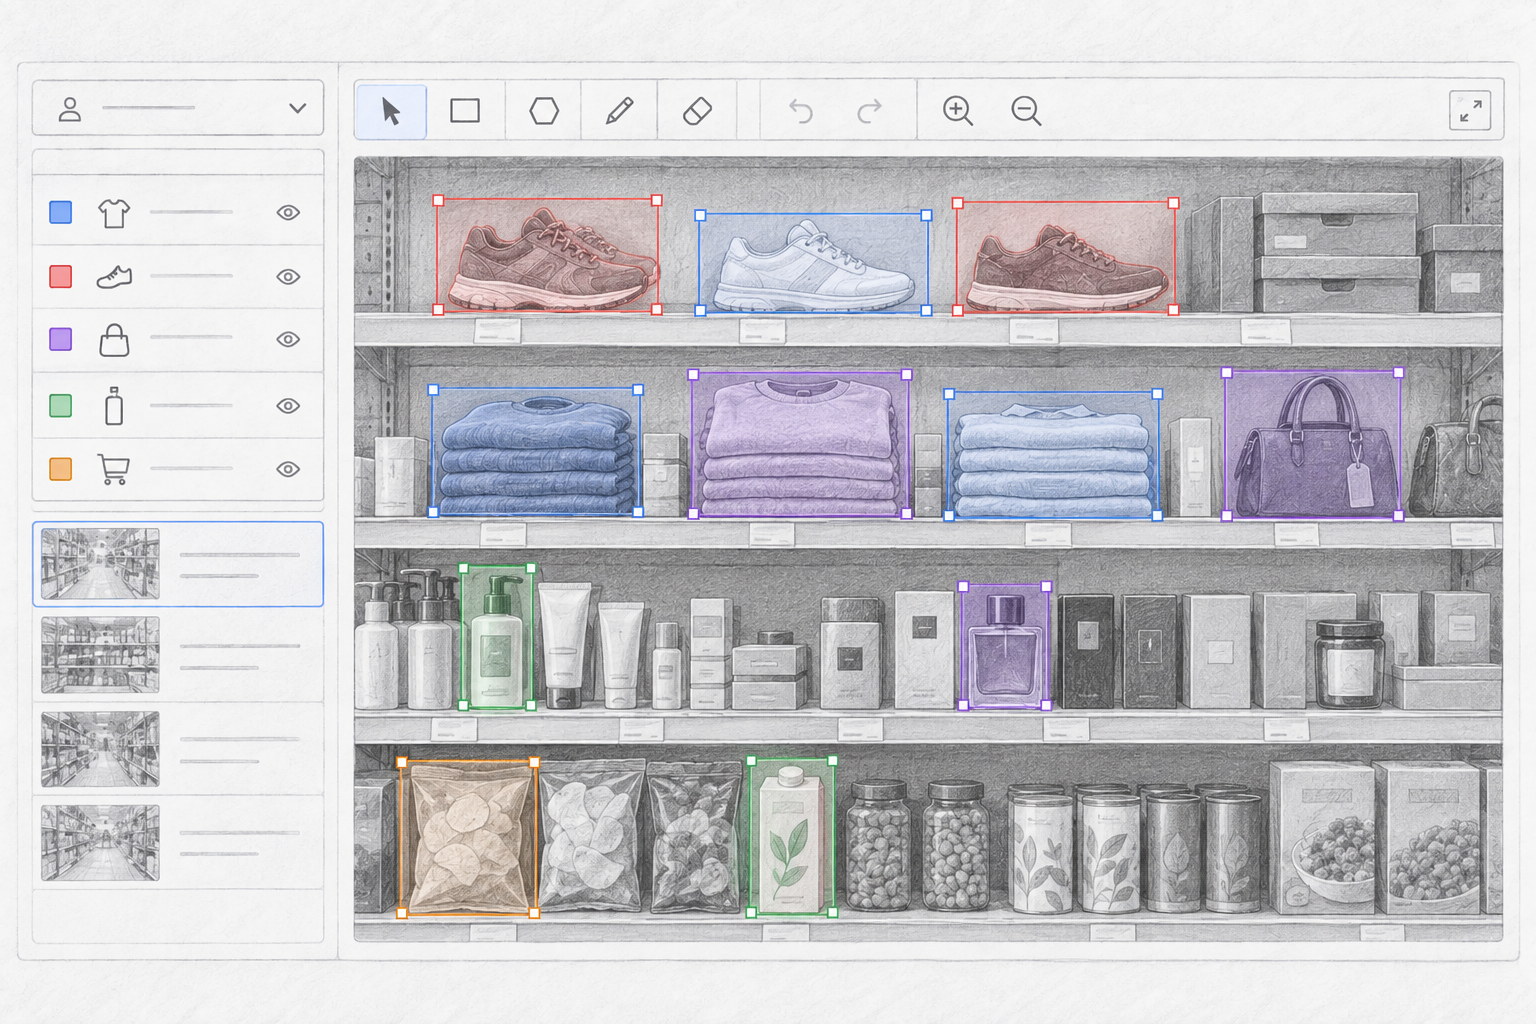
Разметка данных для ритейла и электронной коммерции — это подготовка изображений, видео, текстов и товарных каталогов для обучения моделей искусственного интеллекта.
В зависимости от задачи аннотаторы выделяют товары на фотографиях, присваивают им категории и атрибуты, сегментируют отдельные объекты, распознают текст на упаковке и ценниках или связывают изображения с карточками товаров.
Такие датасеты используются для автоматизации полочной аналитики, распознавания продукции, контроля ассортимента, визуального поиска, классификации товаров и других AI-сервисов.
Особенность ритейла — большое количество похожих объектов. Одна и та же категория может включать сотни или тысячи SKU, которые отличаются цветом, объемом упаковки, размером, моделью или отдельными элементами дизайна.
Поэтому для обучения модели важны не только объем данных, но и единые правила аннотирования, точная структура классов и стабильное качество разметки.
Bounding Box-разметка отдельных товаров, упаковок, ценников, логотипов и других объектов. Подходит для задач распознавания товаров и автоматического анализа изображений торговых полок.
Pixel-perfect или polygon-разметка объектов для точного отделения товара от фона. Используется в визуальном поиске, fashion, генерации каталогов и системах компьютерного зрения.
Присвоение изображениям категорий:
Дополнительные характеристики:
Выделение и распознавание:
Аннотирование товаров на фотографиях и видео торговых залов:
Разные типы аннотации для задач computer vision
Полный цикл подготовки данных - от сырых материалов до готовой модели
Как мы обеспечиваем стабильную разметку товаров
В проектах для ритейла ошибки часто возникают из-за большого количества визуально похожих товаров, сложной структуры категорий и большого числа атрибутов.
Мы фиксируем правила классификации до масштабирования проекта и отдельно описываем пограничные случаи.
Разметка проходит несколько уровней проверки. Особое внимание уделяется правильности классов, полноте аннотаций и согласованности работы разных исполнителей.
Системы компьютерного зрения позволяют автоматически анализировать фотографии и видео из магазинов.
Для обучения таких моделей необходимо корректно определить каждый товар и его положение на полке.
US-DATA может размечать:
Такая разметка применяется в системах контроля мерчандайзинга, автоматического аудита торговых точек и анализа представленности товаров.
Организуем разметку проектов с большим количеством категорий, товаров и атрибутов.
Учитываем не только формальное выполнение разметки, но и то, как структура данных повлияет на обучение модели.
Работаем с вашей классификацией или помогаем формализовать категории и пограничные случаи перед запуском.
Изображения, видео, текст, карточки товаров и другие данные могут обрабатываться в рамках одного проекта.
Можно начать с небольшого пилота и после проверки качества увеличить объем разметки.
Многоступенчатая проверка помогает сохранять одинаковые правила на протяжении всего проекта.
Более точное распознавание товаров
Корректная классификация категорий и SKU
Повышение качества визуального поиска
Стабильная работа с большими товарными каталогами
Готовый датасет для обучения и тестирования модели
Разделы раскрываются — внутри таблицы с ориентировочной стоимостью.
Выберите параметры - получите мгновенный расчет
* Данный расчет не является публичной офертой. Финальная стоимость работ определяется после получения технического задания и анализа данных.
Актуальные материалы о разметке данных и машинном обучении
Расскажите о задаче и покажите пример данных — мы оценим сложность проекта, предложим формат разметки и подготовим тестовую выборку.
Современный ритейл и электронная коммерция активно используют технологии искусственного интеллекта и компьютерного зрения. AI-модели помогают распознавать товары, анализировать выкладку на полках, автоматизировать каталоги, выполнять визуальный поиск и извлекать информацию с упаковок и ценников. Для обучения таких систем необходимы качественно подготовленные и размеченные данные.
US-DATA выполняет разметку изображений и других данных для ритейла и e-commerce. Мы можем выделять отдельные товары с помощью Bounding Box, полигонов и сегментационных масок, классифицировать изображения, присваивать товарам атрибуты и выполнять OCR-разметку текста на упаковке и ценниках.
Одно из важных направлений — подготовка датасетов для распознавания товаров на торговых полках. На одном изображении могут одновременно находиться десятки и сотни объектов, многие из которых визуально похожи друг на друга. При разметке необходимо корректно определить границы товара, категорию, бренд или SKU и одинаково обрабатывать пограничные случаи на всем объеме данных. Для точного контура товара используется сегментация изображений, а для нахождения товара в кадре — детекция объектов.
В e-commerce размеченные данные применяются для визуального поиска, формирования товарных каталогов, классификации изображений и определения характеристик продукции. Особенно актуальны такие задачи для fashion, маркетплейсов, FMCG и компаний с большими товарными каталогами.
US-DATA может подключиться на любом этапе проекта: выполнить тестовую разметку, помочь формализовать гайдлайны, обработать существующий массив данных или масштабировать уже работающий процесс. Многоступенчатая проверка и единые правила разметки позволяют поддерживать согласованность датасета при увеличении объема. Когда каталогу нужна отдельная классификация изображений, правила классов фиксируются до масштабирования.
Если вашему проекту требуется разметка данных для ритейла, датасет товаров, распознавание продукции на полках, классификация каталога или подготовка данных для AI-модели e-commerce, команда US-DATA подготовит данные в согласованном формате для обучения, тестирования и дальнейшего использования модели.