US-DATAРазметка данных
Кабинет
Подготовим медицинские изображения, исследования и документы для обучения AI-моделей — сегментация органов и патологий, классификация, детекция, разметка DICOM и медицинских текстов.
От тестовой разметки до структурированного датасета для обучения и валидации модели.
Рассчитать стоимость проекта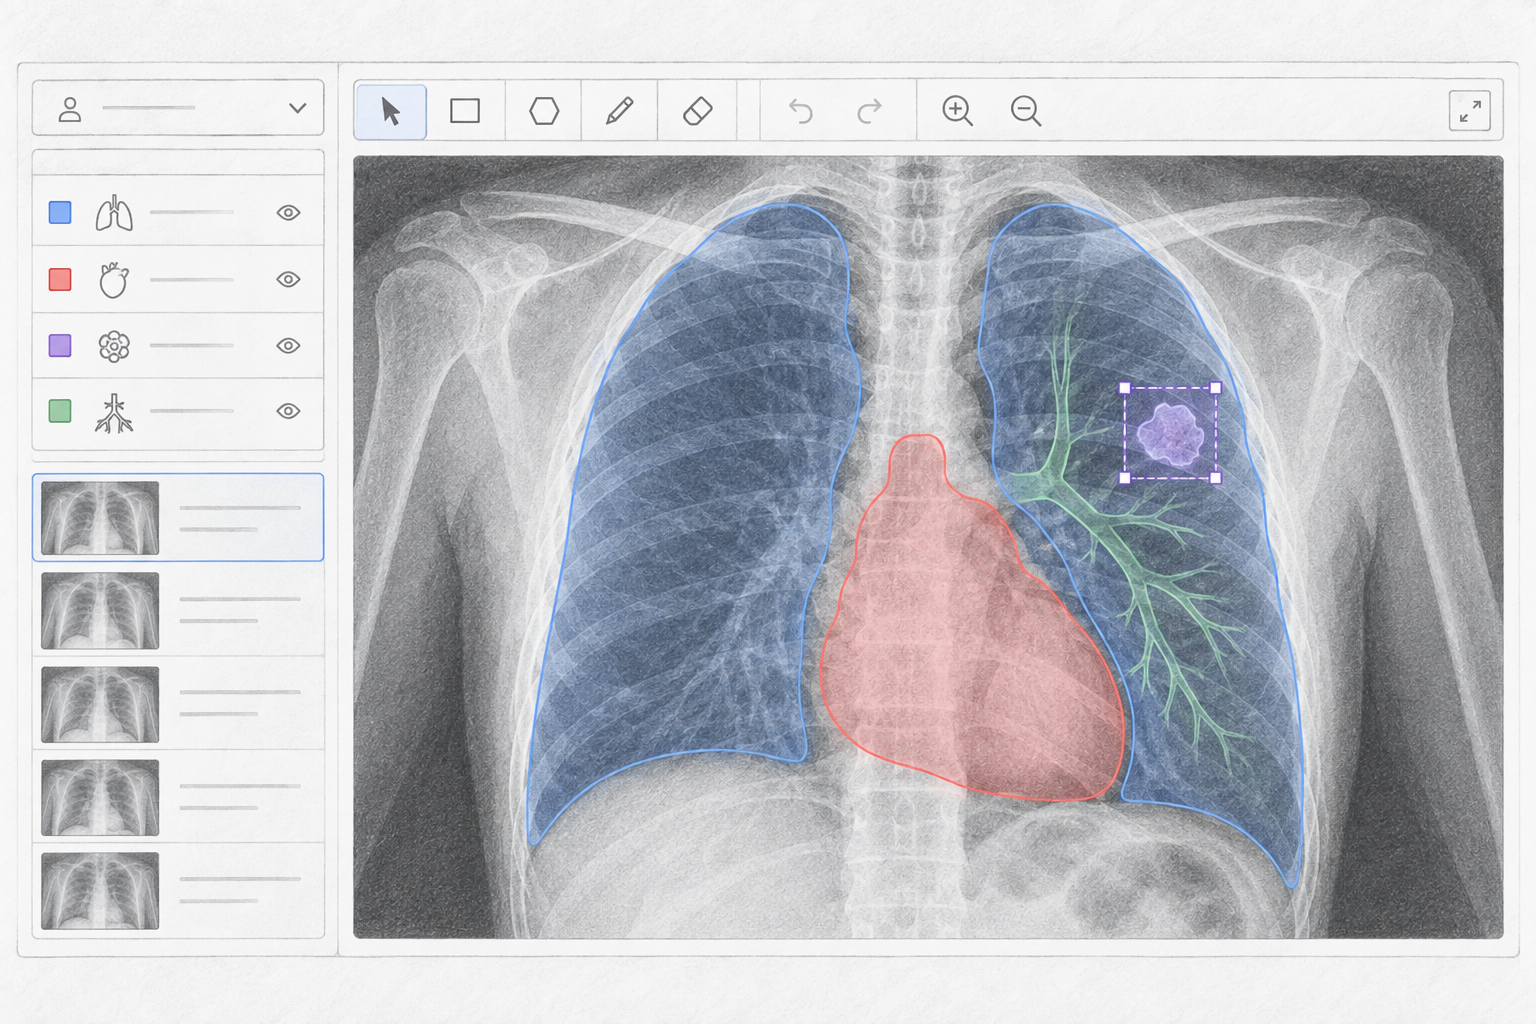
Разметка медицинских данных — это подготовка изображений, исследований, текстов и документов для обучения моделей искусственного интеллекта.
В зависимости от задачи аннотаторы выделяют анатомические структуры, органы, области интереса, патологические изменения, присваивают изображениям классы и размечают текстовую медицинскую информацию.
Для Medical AI могут использоваться рентгеновские снимки, КТ, МРТ, УЗИ, изображения цифровой патологии, микроскопии и другие типы медицинских данных.
Особенность таких проектов — высокая сложность данных и необходимость строгой согласованности аннотаций. Даже небольшие различия в правилах выделения одной и той же области могут существенно менять структуру итогового датасета.
Поэтому перед масштабированием важно определить классы, критерии разметки, формат результата и правила обработки неоднозначных случаев.
Точное выделение:
Выделение зон интереса: новообразований, очагов, повреждений, воспалительных областей и других изменений, определенных техническим заданием. Формат разметки зависит от задачи и может включать Bounding Box, полигоны и сегментационные маски.
Присвоение изображению или исследованию заданных категорий:
Bounding Box или другие типы выделения отдельных объектов и областей интереса.
Разметка ключевых анатомических ориентиров и характерных точек.
Работа с заключениями, протоколами, медицинскими записями, сущностями и атрибутами. Выделение информации из форм, справок, таблиц и других медицинских документов.
Разные типы аннотации для задач computer vision
Полный цикл подготовки данных - от сырых материалов до готовой модели
Как мы обеспечиваем согласованность медицинской разметки
Медицинские данные часто содержат сложные структуры, небольшие области интереса и неоднозначные случаи, поэтому требования к единообразию аннотаций особенно высоки.
Перед запуском проекта фиксируются классы, правила выделения объектов и требования к границам разметки.
На протяжении проекта проводится многоступенчатая проверка, а спорные случаи обрабатываются по заранее согласованной логике.
Medical AI часто работает не с отдельными обычными изображениями, а со специализированными медицинскими исследованиями.
US-DATA может организовать разметку данных для задач, связанных с:
В зависимости от технического задания можно выделять органы, отдельные структуры, области интереса и патологические изменения.
При работе с сериями изображений особенно важно сохранять единые правила разметки между срезами и исследованиями.
Формат результата согласовывается под конкретный ML-пайплайн и программное обеспечение заказчика.
Для многих Medical AI задач недостаточно отметить примерный Bounding Box. Необходимо точно определить границу нужной области на изображении.
Сегментация позволяет создавать пиксельные маски для:
При таких проектах особенно важны единые критерии определения границ и контроль расхождений между аннотациями.
US-DATA организует процесс так, чтобы правила оставались одинаковыми на всем объеме датасета.
Цифровые микроскопические и гистологические изображения могут содержать большое количество мелких объектов и областей интереса.
В зависимости от задачи можно размечать:
Для таких задач могут использоваться Bounding Box, полигоны, точечная разметка, сегментация и классификация.
Организуем разметку данных со сложной структурой, мелкими объектами и неоднозначными границами.
Работаем по инструкции заказчика или помогаем формализовать правила разметки.
Можем адаптировать формат результата под требования ML-пайплайна заказчика.
Проверяем точность, полноту и согласованность аннотаций.
Начинаем с тестовой выборки и масштабируем проект после согласования качества.
При необходимости разметка выполняется в системе заказчика или в согласованном ПО.
Согласованная разметка медицинских изображений
Точная сегментация областей интереса
Структурированный датасет для обучения модели
Единые правила для сложных и пограничных случаев
Готовые данные для обучения, тестирования и валидации ML-модели
Работа с медицинскими данными требует повышенного внимания к безопасности и конфиденциальности. Доступ к материалам получают только специалисты, задействованные в конкретном проекте. При необходимости процесс разметки может быть организован в инфраструктуре или программном обеспечении заказчика.
Разделы раскрываются — внутри таблицы с ориентировочной стоимостью.
Выберите параметры - получите мгновенный расчет
* Данный расчет не является публичной офертой. Финальная стоимость работ определяется после получения технического задания и анализа данных.
Актуальные материалы о разметке данных и машинном обучении
Покажите пример данных и расскажите о задаче — мы оценим объем, требования к аннотации и предложим подход к подготовке датасета.
Искусственный интеллект активно применяется для анализа медицинских изображений, обработки документов и исследовательских задач. Для разработки таких решений требуются качественно подготовленные датасеты с согласованной разметкой.
US-DATA выполняет разметку изображений и других данных для проектов в области Medical AI. В зависимости от задачи мы можем использовать Bounding Box, полигоны, сегментационные маски, классификацию, Keypoints и текстовую разметку.
Одно из ключевых направлений — разметка КТ, МРТ и рентгеновских изображений. На таких данных можно выделять анатомические структуры, органы и заданные области интереса. Для задач, где важна точная геометрия объекта, используется сегментация изображений. Отдельные объекты и зоны также можно выделить через детекцию объектов.
Отдельную категорию составляют проекты цифровой патологии и микроскопии. Такие изображения могут содержать большое количество небольших структур, поэтому процесс разметки требует детальных инструкций и стабильного контроля качества.
US-DATA также может работать с медицинскими документами и текстами. Это включает OCR-разметку, классификацию документов, выделение сущностей и подготовку структурированных данных для NLP-задач на базе разметки текстовых данных.
Для медицинских проектов особенно важны конфиденциальность и контролируемый доступ к исходным данным. Процесс может быть организован с учетом требований заказчика к инфраструктуре, передаче файлов и разграничению доступа.
Перед масштабированием проекта мы рекомендуем провести тестовую разметку. Это позволяет согласовать классы, определить правила для сложных случаев и проверить формат итоговых данных.
Если вашему проекту требуется разметка медицинских изображений, сегментация КТ или МРТ, подготовка данных для Medical AI, цифровой патологии или медицинского NLP, команда US-DATA поможет организовать процесс и подготовить датасет в согласованном формате.