US-DATAРазметка данных
Кабинет
Подготовим звонки, диалоги и голосовые записи для обучения AI-моделей — транскрибация, диаризация спикеров, интенты, тональность, классификация и разметка диалогов.
От тестовой выборки до готового датасета для речевой аналитики, голосовых помощников и контакт-центров.
Рассчитать стоимость проекта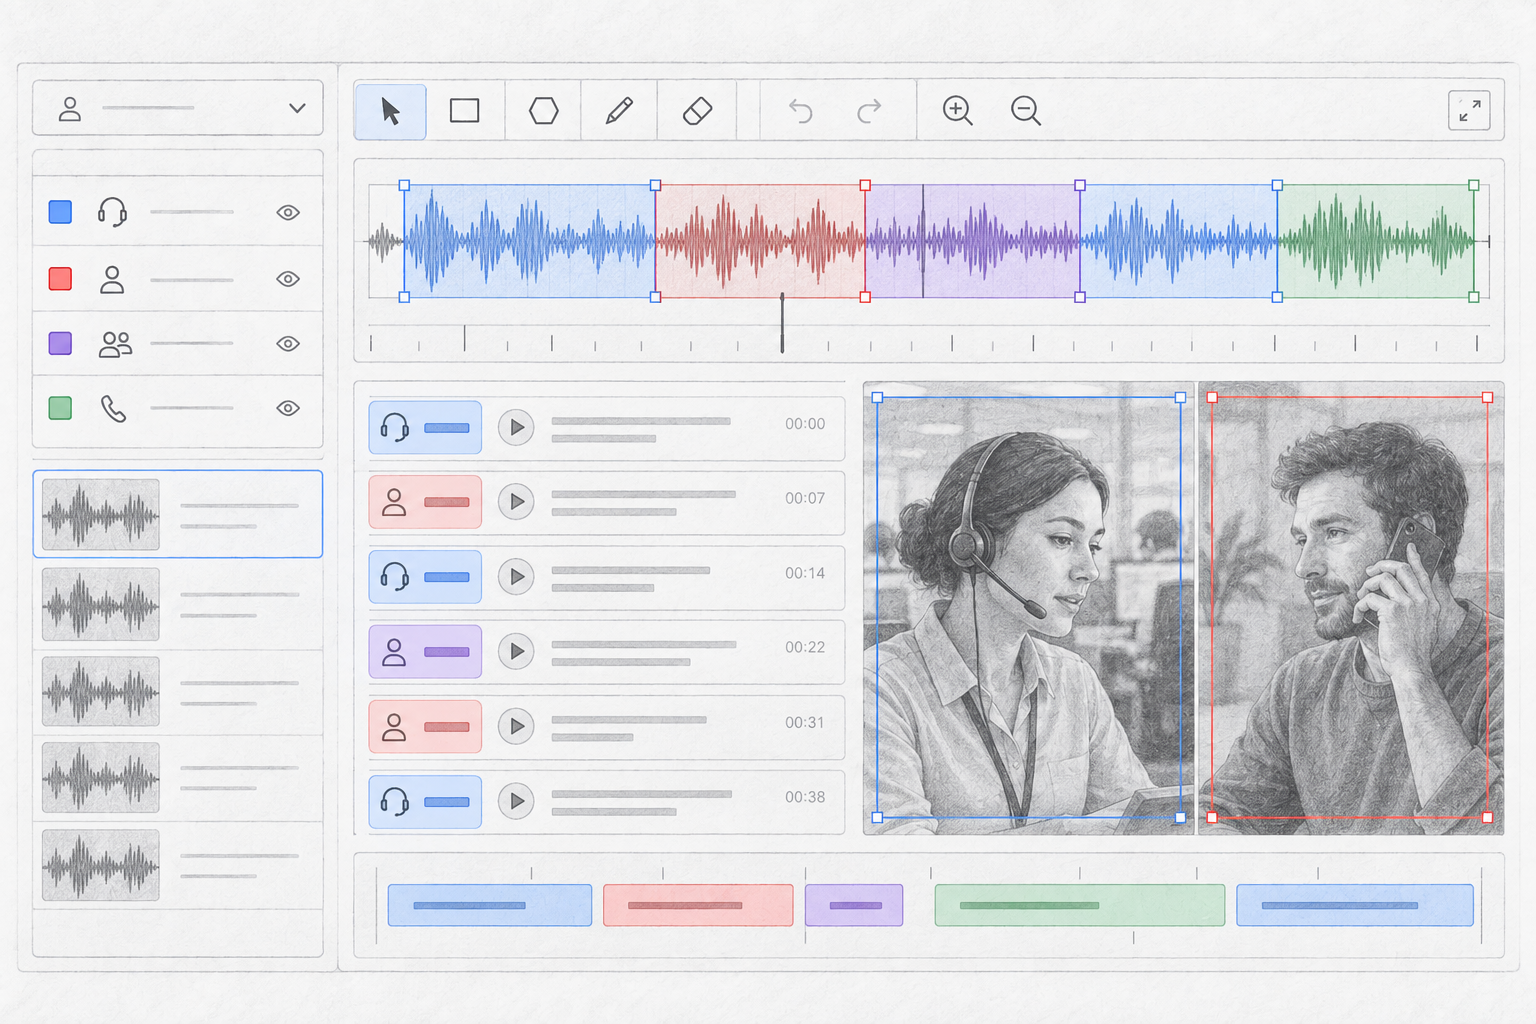
Разметка звонков и голосовых данных — это подготовка аудиозаписей, транскриптов и диалогов для обучения моделей распознавания речи, речевой аналитики, NLP и голосовых помощников.
В зависимости от задачи аудиозапись может быть транскрибирована, разделена по спикерам, разбита на отдельные реплики и дополнена метками интентов, эмоций, тональности, сущностей и других параметров.
Такие датасеты используются для автоматической расшифровки звонков, анализа качества обслуживания, классификации обращений, обучения голосовых ботов и построения систем речевой аналитики.
Особенность разговорных данных — естественная речь. В реальных звонках встречаются перебивания, паузы, фоновые шумы, слова-паразиты, неполные фразы, эмоциональная речь и одновременные реплики нескольких участников.
Поэтому для создания качественного датасета особенно важны единые правила транскрибации, диаризации и классификации.
Преобразование аудиозаписи разговора в текст.
Разделение разговора по участникам: оператор, клиент, несколько собеседников, голосовой бот. Каждой реплике или временному сегменту присваивается соответствующий спикер.
Разбиение записи на:
Определение цели обращения клиента. Структура интентов формируется под конкретный проект.
Выделение в диалогах:
Разметка эмоциональной окраски реплик или всего разговора. Категории по теме обращения, результату, типу клиента, причине и сценарию разговора.
Разные типы аннотации для задач computer vision
Полный цикл подготовки данных - от сырых материалов до готовой модели
Как мы обеспечиваем согласованность разметки звонков
Разговорная речь содержит много неоднозначных случаев: перебивания, паузы, шум, неразборчивые фрагменты и неполные предложения.
Перед запуском проекта мы фиксируем правила транскрибации, разделения спикеров, классификации и обработки спорных случаев.
Разметка проходит несколько уровней проверки, чтобы одни и те же ситуации одинаково обрабатывались на всем массиве данных.
Речевая аналитика позволяет автоматически обрабатывать большие объемы разговоров и превращать неструктурированную речь в данные.
Для обучения таких систем можно размечать:
Такая разметка используется для автоматической классификации звонков, аналитики обращений и обучения NLP-моделей.
Чтобы голосовой помощник правильно понимал пользователя, недостаточно просто расшифровать речь.
Необходимо связать фразу с ее смыслом.
Например, разные формулировки «хочу отменить заказ», «можно отменить доставку?» и «заказ больше не нужен» могут относиться к одному интенту.
US-DATA может размечать пользовательские реплики по интентам, сущностям и дополнительным атрибутам.
Такие данные применяются для обучения систем NLU и диалоговых AI-моделей.
AI-системы позволяют автоматизировать обработку тысяч звонков и анализировать то, что сложно проверять вручную.
С помощью размеченных данных можно обучать модели для:
US-DATA помогает подготовить обучающий датасет под конкретную структуру звонков и бизнес-процесс заказчика.
Реальные звонки редко представляют собой чистую студийную запись.
В данных могут встречаться:
Правила обработки таких случаев фиксируются в гайдлайнах до масштабирования проекта.
Это помогает сохранять единообразие датасета даже на большом объеме звонков.
Можем одновременно обрабатывать исходную аудиозапись и полученный транскрипт.
Помимо транскрибации можем добавлять интенты, сущности, категории и другие смысловые метки.
Работаем по инструкции заказчика или помогаем формализовать правила разметки.
Обрабатываем перебивания, фоновые шумы и другие неоднозначные случаи по согласованным правилам.
Можно начать с тестовой выборки и после проверки качества увеличить объем.
Проверяем транскрипты, разметку спикеров и смысловые категории.
Точные транскрипты звонков
Корректное разделение речи по спикерам
Структурированные интенты и сущности
Данные для речевой аналитики и голосовых помощников
Готовый датасет для обучения и тестирования AI-модели
Записи звонков могут содержать персональную и коммерческую информацию. Доступ к записям и транскриптам получают только специалисты, участвующие в конкретном проекте. При необходимости работа может выполняться в системе заказчика.
Разделы раскрываются — внутри таблицы с ориентировочной стоимостью.
Выберите параметры - получите мгновенный расчет
* Данный расчет не является публичной офертой. Финальная стоимость работ определяется после получения технического задания и анализа данных.
Актуальные материалы о разметке данных и машинном обучении
Покажите пример записей и расскажите о задаче — мы оценим объем, требования к транскрибации и смысловой разметке и предложим оптимальный формат работы.
Звонки, голосовые помощники и контакт-центры генерируют большие объемы неструктурированных речевых данных. Чтобы использовать эти данные для обучения систем искусственного интеллекта, их необходимо преобразовать в структурированный и согласованный датасет.
US-DATA выполняет разметку звонков и голосовых данных для задач распознавания речи, речевой аналитики, NLP и обучения голосовых помощников. В зависимости от проекта мы можем выполнять транскрибацию, диаризацию спикеров, сегментацию аудио, классификацию звонков, разметку интентов, сущностей и тональности. Базовая услуга описана на странице разметки аудио.
Транскрибация звонков превращает аудиозапись в текст, который затем можно использовать для обучения ASR- и NLP-моделей. Отдельная посадочная по транскрибации речи описывает этот формат подробнее. При необходимости разговор дополнительно разделяется по участникам, а каждой реплике присваивается соответствующий спикер.
Для систем речевой аналитики одного транскрипта часто недостаточно. Необходимо определить тему обращения, интент клиента, результат разговора, ключевые сущности и другие параметры. Такая разметка позволяет превращать звонки в структурированные данные. Для сущностей используется NER-разметка, для категорий обращения — классификация текста, для эмоциональной окраски — анализ тональности.
Голосовые помощники и голосовые боты также требуют размеченных диалогов. Разные формулировки одного запроса объединяются в общие интенты, а отдельные слова и фразы размечаются как сущности. Смысловая подготовка текста опирается на разметку текстовых данных. Это помогает AI-системе понимать смысл пользовательского запроса, а не только распознавать речь.
Особую сложность представляют реальные записи колл-центров: перебивания, фоновые шумы, неполные предложения, плохое качество связи и разговорная речь. Перед масштабированием проекта US-DATA фиксирует правила обработки таких случаев и проводит тестовую разметку.
Если вашему проекту требуется транскрибация звонков, разметка голосовых данных, диаризация спикеров, подготовка датасета для речевой аналитики или обучение голосового помощника, команда US-DATA поможет организовать процесс и подготовить данные в согласованном формате для ML- и AI-моделей.