
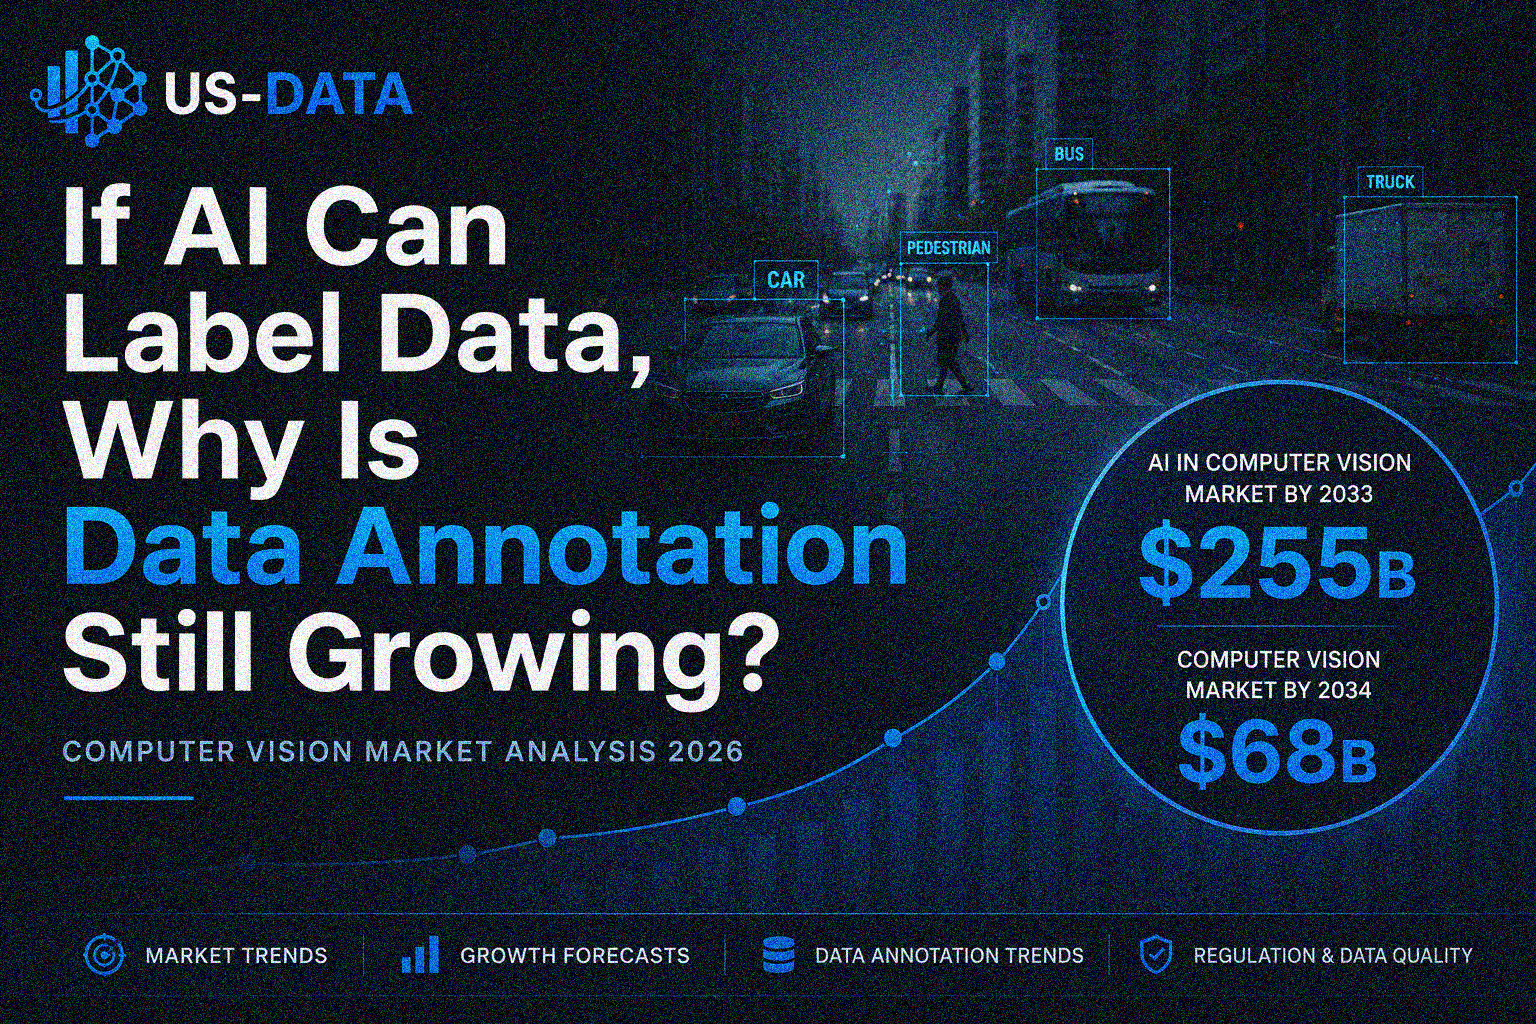
Команда US-DATA подготовила и опубликовала новое аналитическое исследование «Как меняется рынок компьютерного зрения и почему растет значение разметки данных».
Материал посвящен одному из самых обсуждаемых вопросов современной AI-индустрии: действительно ли развитие генеративного искусственного интеллекта, foundation-моделей и автоматической разметки приведет к снижению спроса на услуги Data Annotation?
Исследование показывает, что ситуация складывается иначе. Несмотря на активное внедрение AI-инструментов, рынок разметки данных продолжает расти, а требования к качеству обучающих датасетов становятся только выше. Автоматизация берет на себя выполнение рутинных задач, тогда как экспертная разметка, контроль качества и работа со сложными сценариями становятся ключевыми факторами успешного внедрения систем искусственного интеллекта.
В рамках исследования специалисты US-DATA проанализировали прогнозы ведущих мировых аналитических агентств, включая Mordor Intelligence, IMARC Group, SkyQuest, Statista, MarketsandMarkets, Coherent Market Insights и других. Кроме рыночной аналитики, материал содержит практические выводы, основанные на опыте реализации проектов по подготовке данных для машинного обучения и компьютерного зрения.
О чем исследование
В статье рассмотрены:
- перспективы развития мирового рынка Computer Vision;
- темпы роста сегмента AI in Computer Vision;
- влияние foundation-моделей и автоматической разметки на рынок Data Annotation;
- роль экспертной разметки и контроля качества данных;
- интеграция процессов подготовки данных в MLOps;
- влияние требований EU AI Act на качество и управление данными.
Исследование будет полезно ML-инженерам, специалистам по Data Science, руководителям цифровых проектов, AI-командам и компаниям, которые разрабатывают или внедряют решения на базе искусственного интеллекта.
Читать исследование
📖 Как меняется рынок компьютерного зрения и почему растет значение разметки данных
Решения US-DATA для подготовки данных
US-DATA предоставляет полный спектр услуг по подготовке данных для обучения моделей искусственного интеллекта:
- разметка изображений;
- детекция объектов (Bounding Box);
- семантическая и instance-сегментация;
- polygon annotation;
- keypoint annotation;
- OCR и разметка документов;
- разметка видео и трекинг объектов;
- классификация изображений;
- разметка текста и аудио;
- сбор данных (Data Collection);
- подготовка датасетов для Machine Learning и LLM;
- контроль качества (QA) и аудит разметки.
Подробнее обо всех услугах компании:
Следите за публикациями в разделе Новости — мы регулярно делимся отраслевой аналитикой, исследованиями рынка и практическими материалами о технологиях искусственного интеллекта, машинного обучения и подготовки данных.