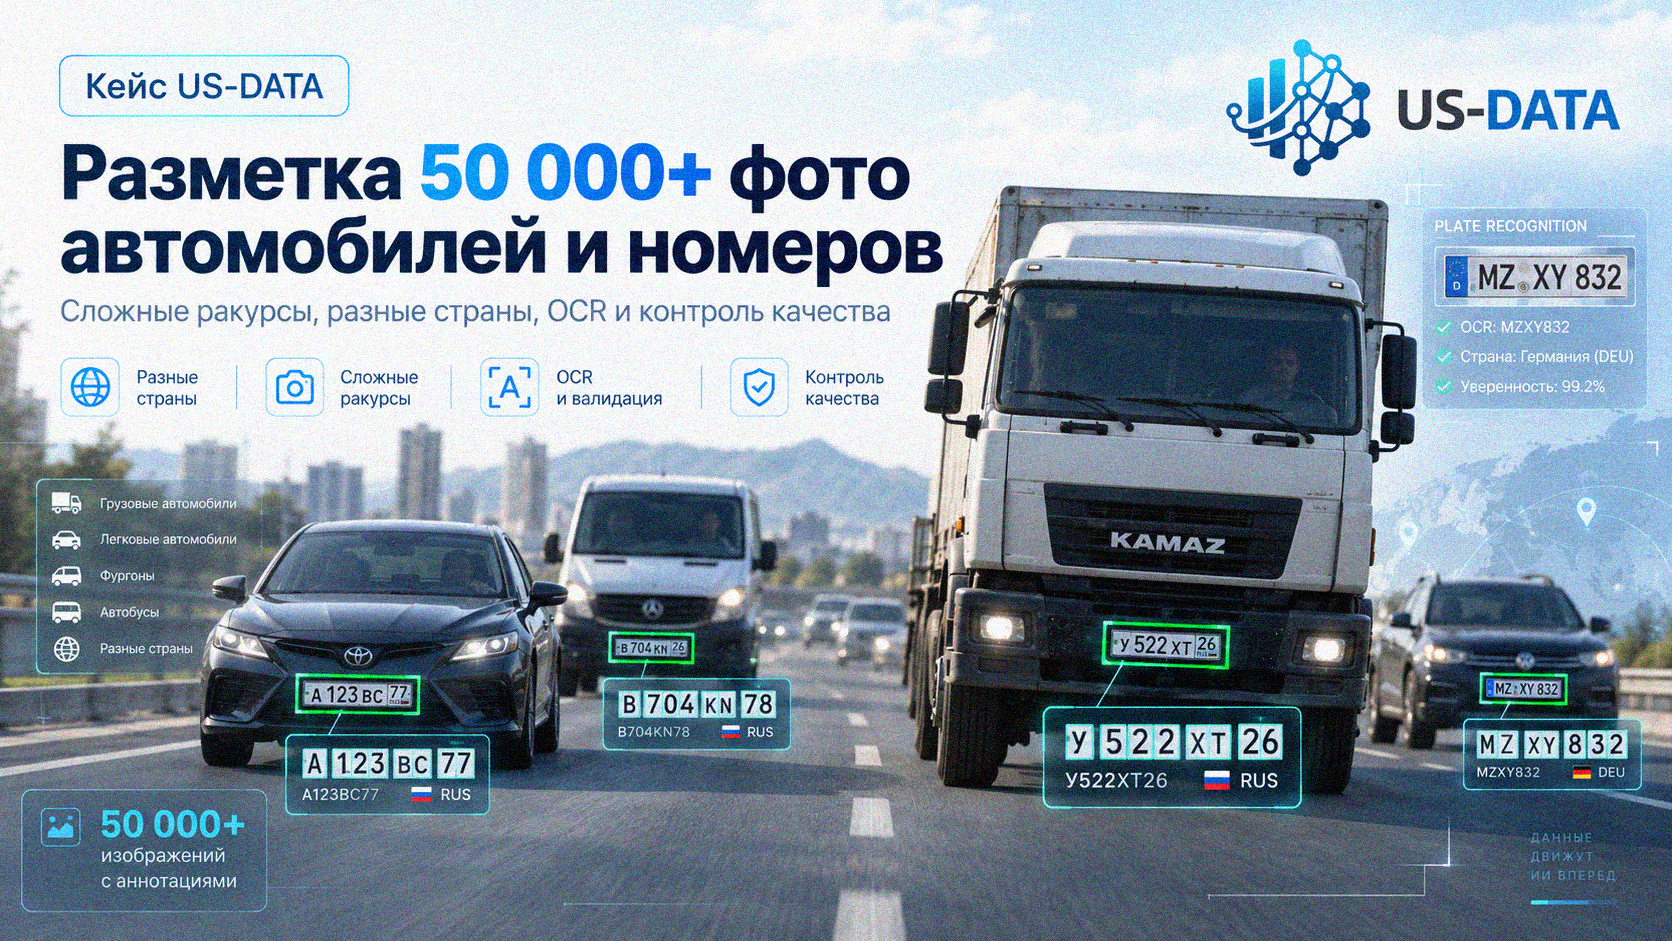
Как подготовить большой датасет для компьютерного зрения, если на одном изображении может находиться несколько автомобилей, номера сняты под разными углами, символы частично закрыты грязью и бликами, а транспорт относится к разным странам? Рассказываем о проекте US-DATA по разметке более 50 тысяч фотографий для системы автоматического распознавания автомобильных номеров.
Задача проекта
Команда US-DATA получила массив из более чем 50 000 фотографий транспортных средств для подготовки обучающего датасета системы компьютерного зрения.
Задача модели заключалась не только в обнаружении автомобиля или номерного знака. Система должна была научиться определять положение регистрационного номера на фотографии, считывать его символы и учитывать дополнительные параметры объекта.
При этом датасет нельзя было рассматривать по принципу «одна фотография — один автомобиль». На части изображений одновременно присутствовало несколько транспортных средств, поэтому каждый релевантный объект требовалось обнаружить и корректно описать.
Дополнительную сложность создавала география данных: в выборке встречались регистрационные знаки разных стран, отличающиеся форматом, расположением символов, национальными обозначениями и визуальным оформлением.
Что нужно было размечать
Для каждого подходящего объекта выполнялось несколько связанных операций.
1. Локализация номерного знака
Аннотатор определял местоположение регистрационной пластины и выделял ее рамкой. Такая разметка используется для обучения моделей детекции объектов: алгоритм должен понять не только, что номер присутствует в кадре, но и где именно он находится.
2. Расшифровка номера
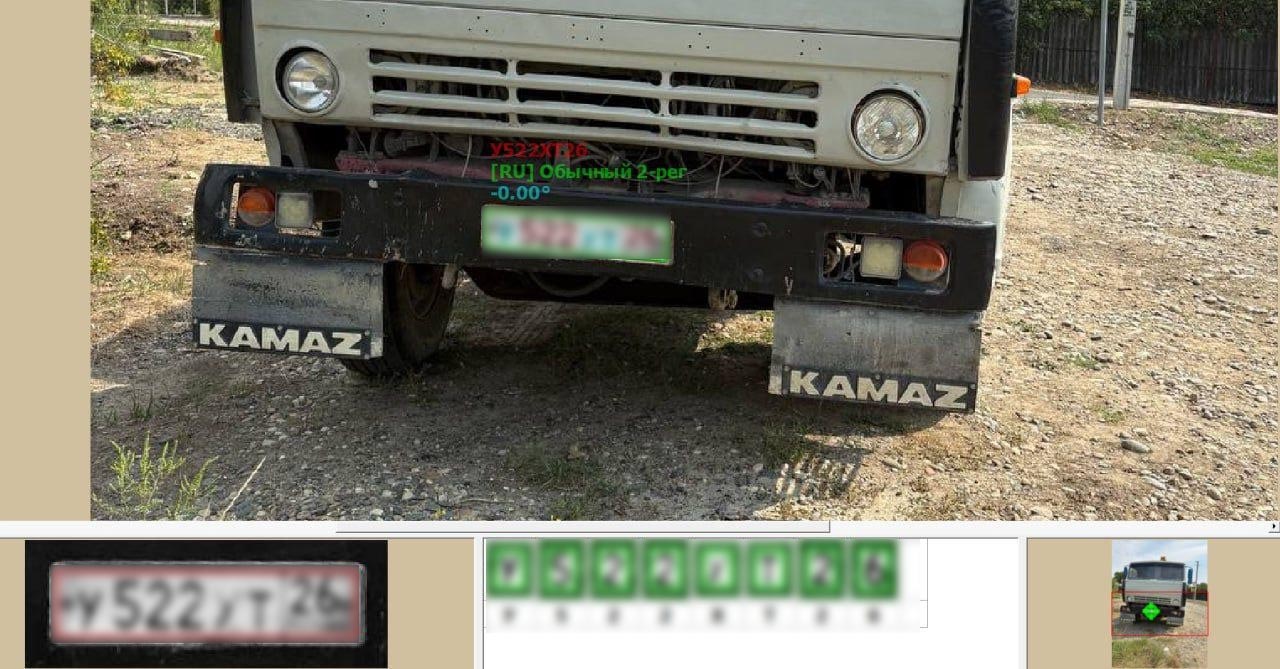
Текст номерного знака переносился в структурированное текстовое значение. По сути, разметка одновременно решала задачу подготовки данных для последующего OCR — распознавания символов на изображениях.
Например, системе важно научиться отличать визуально похожие символы: С/C, Р/P, У/Y, а также Y/V, 0/O и другие сочетания, особенно если изображение имеет низкое качество.
3. Определение страны
Для регистрационного знака указывалась страна. Если соответствующий код присутствовал и читался однозначно, использовалась эта информация.
В более сложных случаях страну требовалось определять по структуре и формату номерного знака.
4. Определение типа транспортного средства
Дополнительно объект классифицировался по типу транспорта — например, легковой автомобиль, грузовой транспорт или мотоцикл.
Таким образом, одно изображение могло содержать сразу несколько объектов, а каждый объект — несколько связанных типов аннотаций.
Почему 50 000 фотографий — это не 50 000 простых заданий
Объем изображения сам по себе еще ничего не говорит о реальной сложности проекта.
Если на одной фотографии находятся три автомобиля, разметчику необходимо обнаружить и проверить несколько объектов. Если регистрационный знак плохо читается, количество решений и проверок дополнительно возрастает.
Именно поэтому в задачах компьютерного зрения правильнее оценивать не только количество файлов, но и плотность объектов, количество атрибутов и сложность каждого изображения.
В этом проекте наиболее трудными оказались несколько групп данных.
Грязные и поврежденные номера
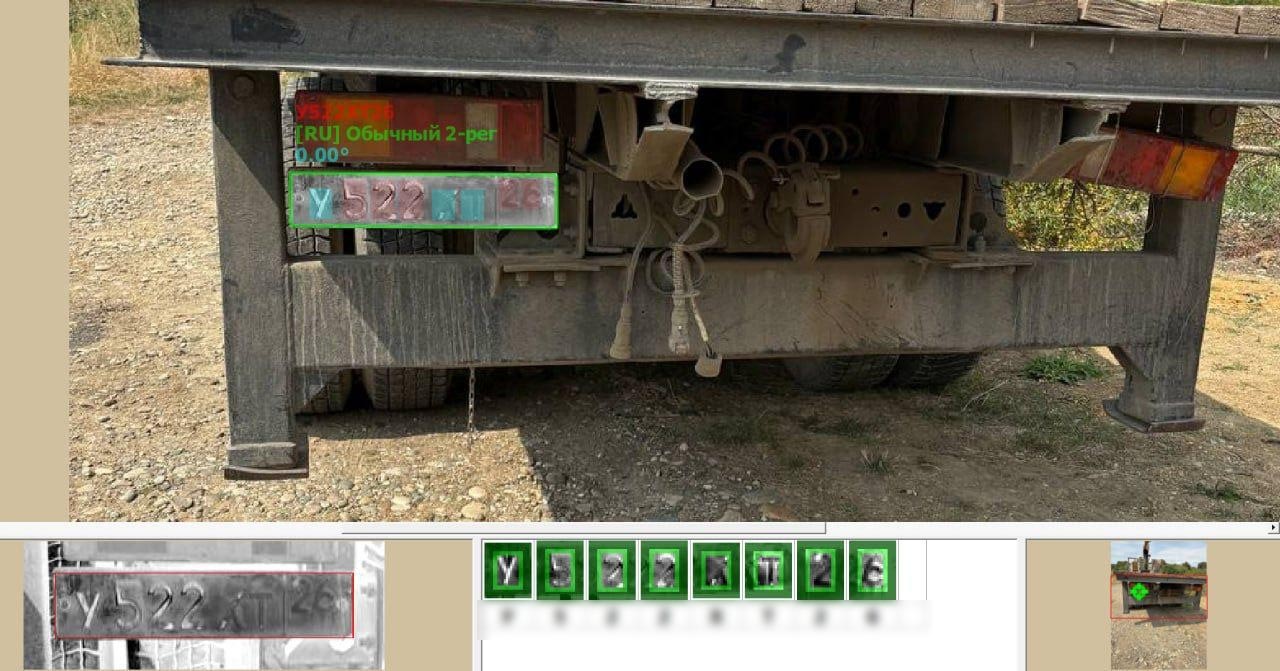
Реальные дорожные изображения сильно отличаются от аккуратных примеров из открытых датасетов.
На номерных знаках встречались:
- грязь;
- снег;
- дорожные реагенты;
- потертости;
- повреждения;
- пленка и другие покрытия;
- частично исчезнувшие символы.
В некоторых случаях часть регистрационного номера визуально практически отсутствовала.
Для обучения реальной системы распознавания такие изображения особенно ценны: модель будет сталкиваться именно с ними после запуска.
Блики, засветка и ночная съемка
Еще одна сложность — освещение.
Отражающая поверхность регистрационного знака хорошо видна человеку днем, но при использовании вспышки или другого интенсивного источника света номер может превратиться на изображении практически в одно белое пятно.
Ночные изображения поэтому требовали отдельного внимания.
Важно было определить границу между случаем, когда символ еще можно уверенно прочитать, и изображением, где восстановление значения уже основывалось бы на предположении.
Для датасета это принципиальный вопрос: разметчик не должен додумывать то, чего объективно нет в исходных данных.
Нестандартные ракурсы и перспектива
Автомобили не всегда снимались прямо.
В датасете встречались фотографии:
- под сильным углом;
- практически с уровня земли;
- сверху;
- сбоку;
- с большой перспективной деформацией;
- с частично закрытым автомобилем;
- с номером на значительном удалении.
В результате прямоугольная регистрационная пластина на фотографии могла выглядеть как сильно искаженный четырехугольник, занимать небольшую часть кадра или частично скрываться элементами автомобиля.
Для модели такие примеры необходимы, поскольку будущая система должна обнаруживать номер независимо от положения камеры.
Смешение кириллицы и латиницы
Отдельный класс ошибок связан не с качеством фотографии, а с самими символами.
Российские автомобильные номера используют набор букв кириллицы, графически совпадающих или очень похожих на латинские. При плохом разрешении разница между отдельными символами становится минимальной.
Например:
С / C
Р / P
У / Y
При этом в международном датасете одновременно могут находиться номера разных стран.
Для человека контекст позволяет быстро определить правильное значение. Для модели качество такой разметки непосредственно определяет, научится ли она различать эти случаи.
Несколько автомобилей на одной фотографии
Еще один важный сценарий — изображения с несколькими транспортными средствами.
В таком кадре нельзя просто найти «главный» автомобиль. Необходимо последовательно проверить всю сцену, определить требуемые объекты и связать каждый номер с соответствующим транспортным средством и его атрибутами.
Это превращает задачу из обычного распознавания отдельного объекта в полноценную разметку сложной сцены для computer vision.
Именно такие изображения особенно хорошо показывают разницу между простой классификацией фотографии и профессиональной объектной разметкой.
Как организовать разметку большого датасета
Главная задача при масштабировании — сохранить одинаковую логику аннотации на первой, десятитысячной и пятидесятитысячной фотографии.
Поэтому перед основной разметкой формируется единый набор правил.
В нем фиксируется:
- что считать регистрационным номером;
- как выделять его границы;
- как работать с частично закрытыми объектами;
- что делать с нечитаемыми символами;
- как обозначать неоднозначные случаи;
- как определять страну;
- какие типы транспорта использовать;
- когда изображение или объект необходимо отправить на дополнительную проверку.
Сложные примеры отдельно разбираются и превращаются в эталонные кейсы для всей команды.
Так гайдлайн развивается вместе с проектом, а нестандартные ситуации не приводят к появлению нескольких разных правил внутри одного датасета.
Контроль качества
При больших объемах ошибка отдельного исполнителя быстро превращается в системную проблему.
Если часть команды размечает один и тот же тип номера по одному правилу, а другая часть — по другому, нейросеть получает противоречивые обучающие данные.
Поэтому в проекте использовались единые инструкции и дополнительная проверка результатов.
Особое внимание уделялось пограничным ситуациям:
- плохо читаемым символам;
- нестандартным номерным знакам;
- необычным ракурсам;
- изображениям плохого качества;
- неоднозначному определению страны;
- нескольким объектам в одном кадре.
При необходимости спорные примеры отдельно разбирались и после принятия решения использовались как образец для дальнейшей работы.
Что получил заказчик
Результатом проекта стал структурированный массив из более чем 50 тысяч размеченных фотографий, подготовленный для дальнейшего обучения системы компьютерного зрения.
В датасете была объединена информация нескольких уровней:
изображение → транспортное средство → номерной знак → текст номера → страна → тип транспорта.
Такой подход позволяет использовать данные не только для одной узкой задачи.
Один подготовленный массив может быть задействован при обучении и тестировании нескольких компонентов системы:
- детектора номерных знаков;
- алгоритма распознавания символов;
- классификатора транспортных средств;
- определения страны регистрационного знака;
- комплексных систем автоматического распознавания номеров.
Почему реальные данные особенно важны для распознавания номеров
Модель легко показать хорошие результаты на наборе фотографий, где автомобили сняты днем, фронтально, а все регистрационные знаки чистые и хорошо читаются.
Production-среда выглядит иначе.
Камера может быть установлена слишком высоко или слишком низко. Автомобиль движется. Идет дождь или снег. Номер загрязнен. Часть символов находится в тени. В кадре несколько машин. Камера работает ночью.
Поэтому задача подготовки датасета заключается не в создании максимально «красивой» выборки.
Наоборот, качественный датасет должен отражать вариативность реального мира, с которой система встретится после внедрения.
Именно на таких данных модель учится работать не только в лабораторных условиях.
Какие задачи решает подобная разметка
Разметка автомобилей и регистрационных знаков может использоваться в проектах:
- автоматического распознавания автомобильных номеров — ANPR/ALPR;
- интеллектуальных транспортных систем;
- контроля въезда и выезда;
- парковочных систем;
- платных автомобильных дорог;
- городской видеоаналитики;
- мониторинга транспорта;
- логистики;
- систем безопасности;
- компьютерного зрения для транспортной инфраструктуры.
С технической точки зрения проект объединяет сразу несколько востребованных направлений: разметку изображений, object detection, bounding box, классификацию, OCR-разметку и подготовку датасета для компьютерного зрения.
US-DATA: разметка изображений для сложных задач компьютерного зрения
US-DATA выполняет разметку изображений и подготовку датасетов для обучения систем компьютерного зрения — от пилотной выборки до проектов с десятками и сотнями тысяч файлов.
Мы можем подключиться как к отдельному этапу разметки, так и помочь выстроить процесс: формализовать требования, подготовить правила аннотации, провести тестовый этап, масштабировать команду и организовать контроль качества.
Работа с реальными данными почти всегда содержит пограничные случаи. Поэтому задача профессиональной разметки — не только быстро обработать большой объем файлов, но и добиться того, чтобы весь датасет оставался логически единым.
Услуги, использованные в подобных проектах
- Разметка данных для машинного обучения