US-DATA数据标注
机柜
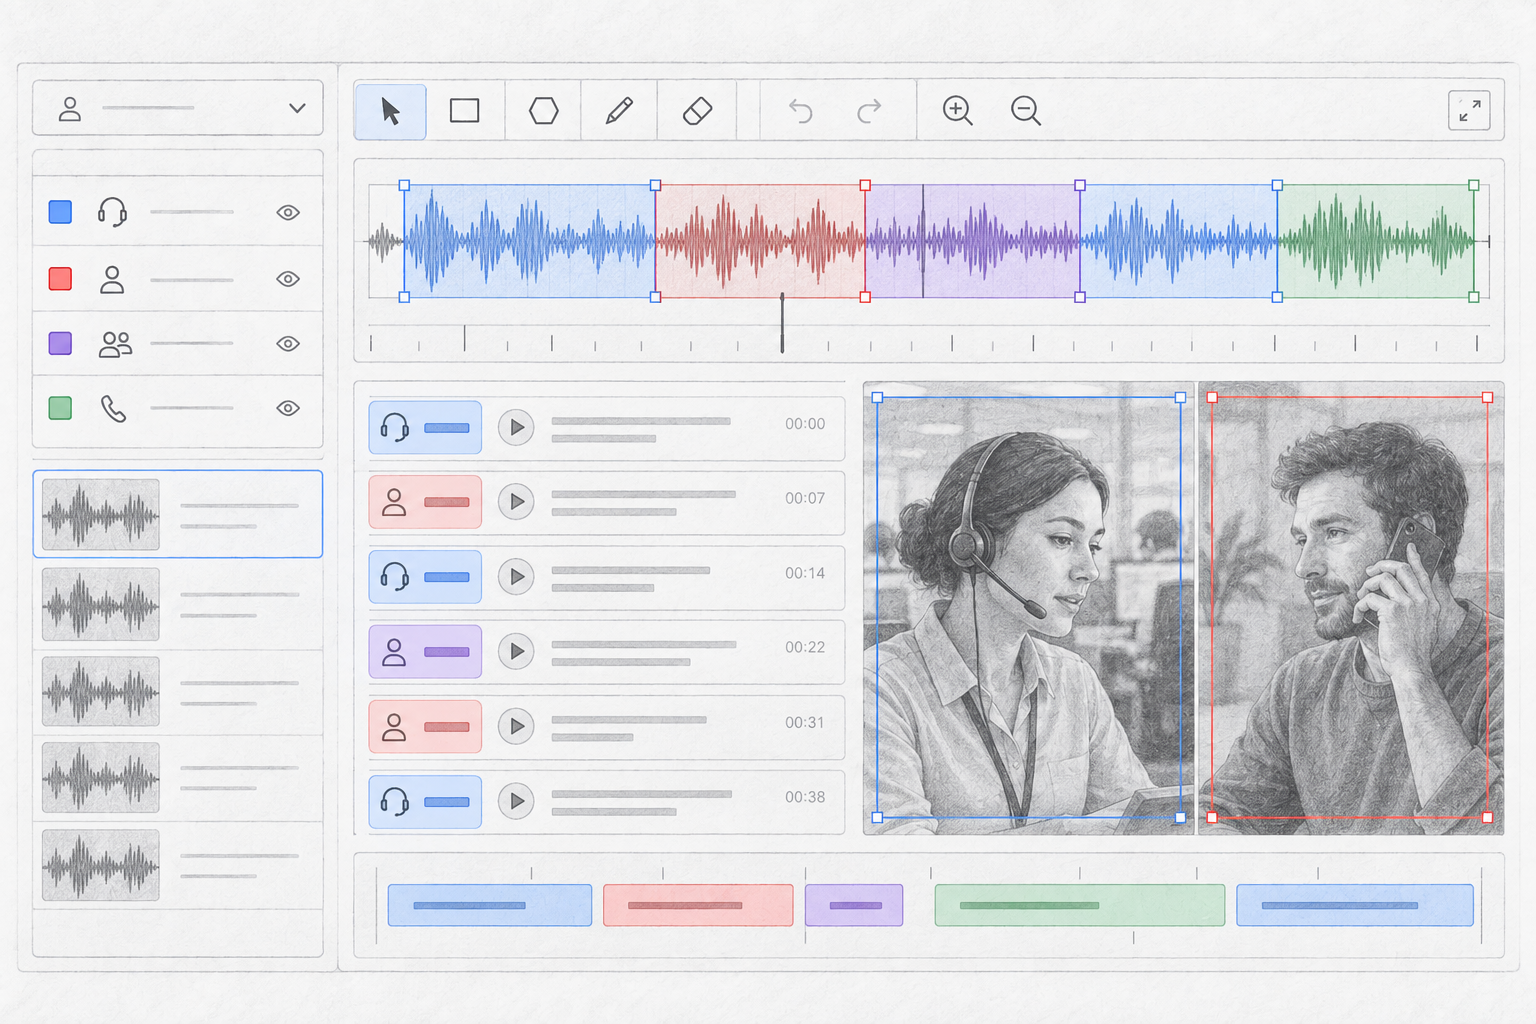
通话与语音数据标注,是为语音识别、语音分析、NLP 和语音助手准备录音、转写文本和对话。
根据任务,录音可以被转写、按说话人分开、切成单句,并补充意图、情绪、情感、实体和其他标签。
这类数据集用于自动转写通话、服务质量分析、来电分类、语音机器人训练和语音分析系统。
对话数据的特点是自然语音。真实通话中会有插话、停顿、背景噪声、口头禅、不完整的句子、情绪化表达,以及多人同时说话。
因此,高质量数据集尤其需要统一的转写、说话人分离和分类规则。
把对话录音转换为文本。
按参与者分开对话:座席、客户、多位谈话人、语音机器人。每句话或每个时间片段都会对应到相应说话人。
把录音分成:
判断客户来电目的。意图结构按具体项目确定。
在对话中标出:
标注单句或整段对话的情感色彩。按来电主题、结果、客户类型、原因和对话场景分类。
计算机视觉任务的不同标注类型
从原始数据到模型就绪输出的完整数据准备周期
我们如何保证通话标注一致
口语中有很多含义不清的情况:插话、停顿、噪声、听不清的片段和不完整的句子。
项目启动前,我们固定转写、说话人分离、分类和争议情况的处理规则。
标注经过多层检查,使相同情况在全部数据上以同样方式处理。
语音分析可以自动处理大量对话,把非结构化语音变成数据。
训练这类系统时可以标注:
这类标注用于自动分类通话、来电分析和 NLP 模型训练。
要让语音助手正确理解用户,只转写语音是不够的。
必须把说法和它的含义联系起来。
例如,“我想取消订单”“可以取消配送吗?”“订单不再需要了”可以属于同一个意图。
US-DATA 可以按意图、实体和其他属性标注用户话语。
这些数据用于训练 NLU 系统和对话式 AI 模型。
AI 系统可以自动处理成千上万通电话,并分析人工很难逐条检查的内容。
借助标注数据,可以训练用于以下任务的模型:
US-DATA 会按客户的通话结构和业务流程准备训练数据集。
真实通话很少是干净的录音棚录音。
数据中可能出现:
这些情况的处理规则会在项目扩大之前写入指南。
这有助于即使在大量通话上也能保持数据集一致。
可以同时处理原始录音和得到的转写文本。
除转写外,还可以添加意图、实体、类别和其他语义标签。
按客户说明工作,或帮助把标注规则整理成文。
按约定规则处理插话、背景噪声和其他含义不清的情况。
可以先做测试样本,确认质量后再增加数据量。
检查转写、说话人标注和语义类别。
准确的通话转写
按说话人正确分离语音
结构化的意图和实体
可用于语音分析和语音助手的数据
可用于训练和测试的数据集
通话录音可能包含个人和商业信息。只有参与具体项目的专家才能访问录音和转写。必要时,工作可以在客户系统中完成。
带有参考费用表的可展开部分。
选择参数,立即获得估算
* 此估算并非公开报价。最终费用将在技术分析和数据审查后确定。
数据标注和机器学习的最新资料
通话、语音助手和联络中心会产生大量非结构化语音数据。要把这些数据用于训练人工智能系统,就需要把它变成结构清晰、标注一致的数据集。
US-DATA 为语音识别、语音分析、NLP 和语音助手标注通话与语音数据。根据项目,我们可以做转写、说话人分离、音频切分、通话分类、意图、实体和情感标注。基础服务见音频标注页面。
通话转写把录音变成文本,随后可用于训练 ASR 和 NLP 模型。语音转写页面更详细地说明了这一形式。必要时,对话还会按参与者分开,并为每句话指定说话人。
对语音分析系统来说,往往只有转写是不够的。还需要判断来电主题、客户意图、对话结果、关键实体和其他参数。实体使用NER 标注,来电类别使用文本分类,情感色彩使用情感分析。
语音助手和语音机器人同样需要标注过的对话。同一请求的不同说法会归入共同意图,单词和短语则标为实体。文本的语义准备依托文本数据标注。这帮助 AI 系统理解用户请求的含义,而不只是识别语音。
呼叫中心的真实录音尤其复杂:插话、背景噪声、不完整的句子、通话质量差和口语。在扩大规模之前,US-DATA 会固定这些情况的处理规则,并做测试标注。
如果您的项目需要通话转写、语音数据标注、说话人分离、语音分析数据集或语音助手训练,US-DATA 会帮助组织流程,并按约定格式为 ML 和 AI 模型准备数据。