
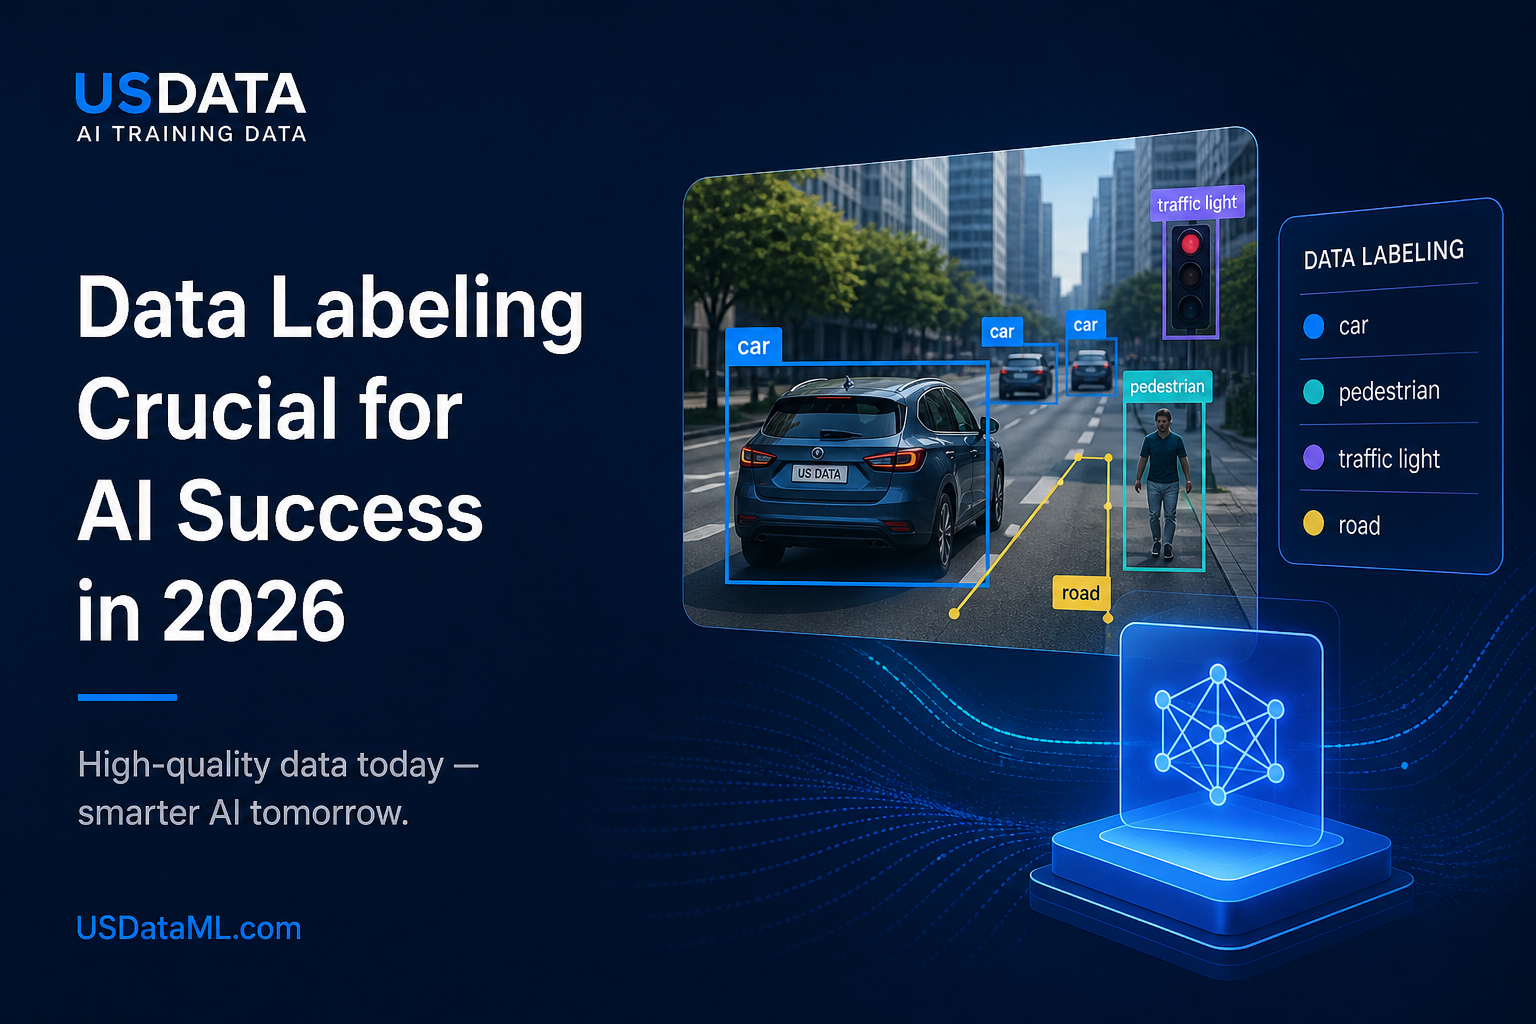
什么是数据标注及其重要性
数据标注是原始数据与机器学习模型之间的解释层。只要图像、文本、音频或视频流没有清晰的结构,对算法而言它们只是一组信号:像素、词元、振幅、时间片段。标注正是将这种“原始流”转化为训练数据集的过程,使模型能够发现模式并学习如何做出决策。
简单来说,标注告诉系统它正在看什么。不是“一张1024×768的图像”,而是画面特定区域中的一辆汽车。不是“一行字符”,而是客户投诉、日期、品牌名称或地址。不是“一段37秒的音频文件”,而是两位说话者的语音,包含停顿、语调变化和特定话语。这一层的质量影响巨大:如果训练数据标注粗心,即使强大的模型架构也会很快在性能上遇到瓶颈。
以车辆检测任务为例。仅仅将数千张图像上传到流程中是不够的。对于每一帧,你需要指定物体的确切位置、所属类别,并且在许多场景中,还需要细化其形状、关键点或像素掩码。没有这种准备,神经网络无法将“汽车”视为一个实体——它只能在没有上下文的情况下操作数字。这就是为什么在真实的ML项目中,标注质量对最终结果的影响往往与模型架构的选择同等甚至更重要。
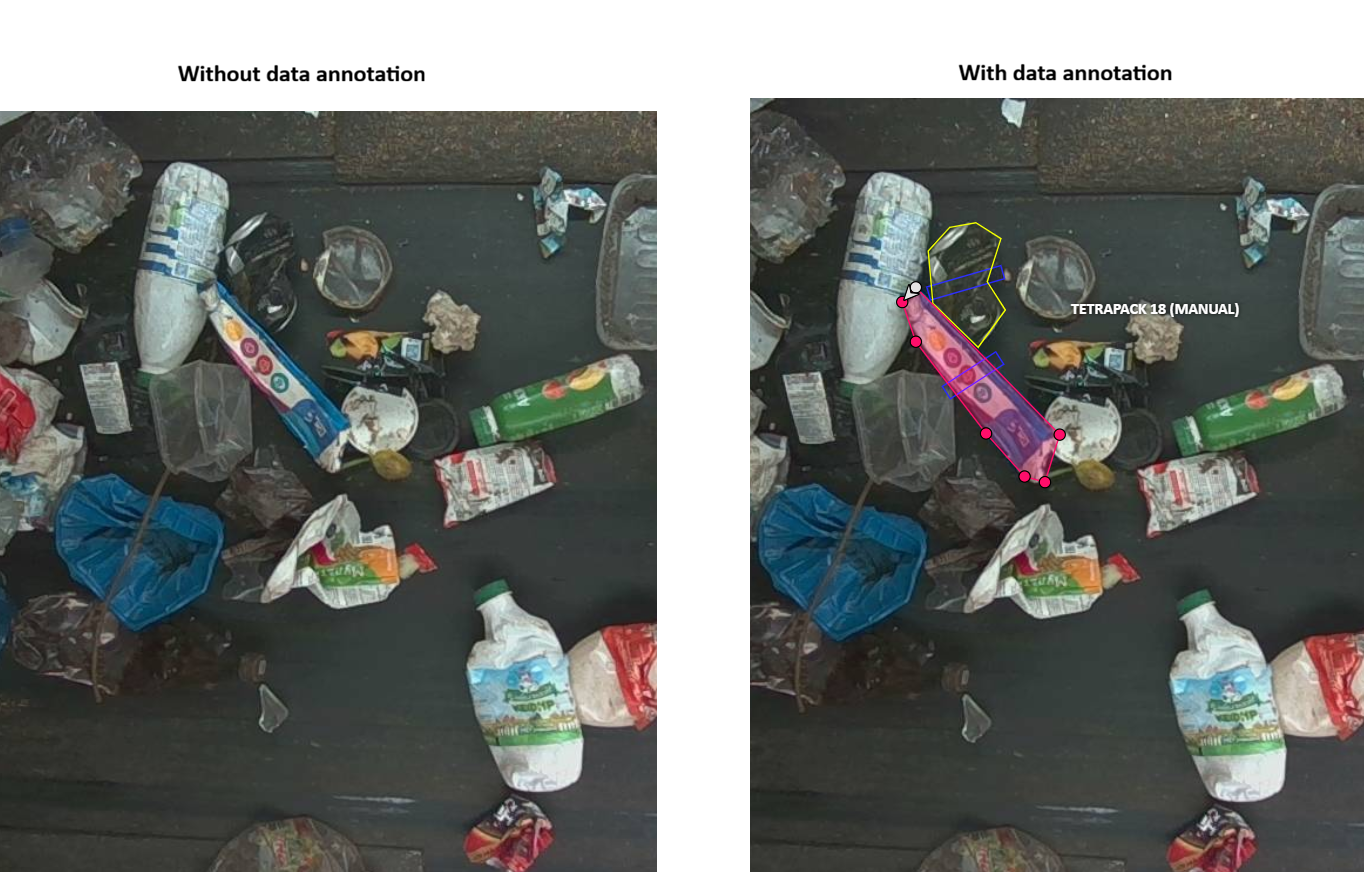
对于计算机视觉任务,具体的标注格式和示例可以在 图像标注页面 上找到。
数据标注的主要类型
标注类型的选择从来不是“凭习惯”,而是根据具体的ML任务、数据模态和可接受的错误成本。同一数据集可以以不同方式标注:快速粗略地获取基线模型,或深入细致地满足高生产精度要求。
在实践中,标注通常分为四大类:图像、文本、音频和视频。这正是 US-DATA 所处理的数据类型。
图像标注
图像标注在模型需要理解视觉场景的任何地方都是必需的:计算机视觉系统、工业分析、零售、安防、交通和医疗技术。在US-DATA图像标注页面上,您可以找到关键格式:边界框、多边形、掩码、关键点、分类和图像描述。
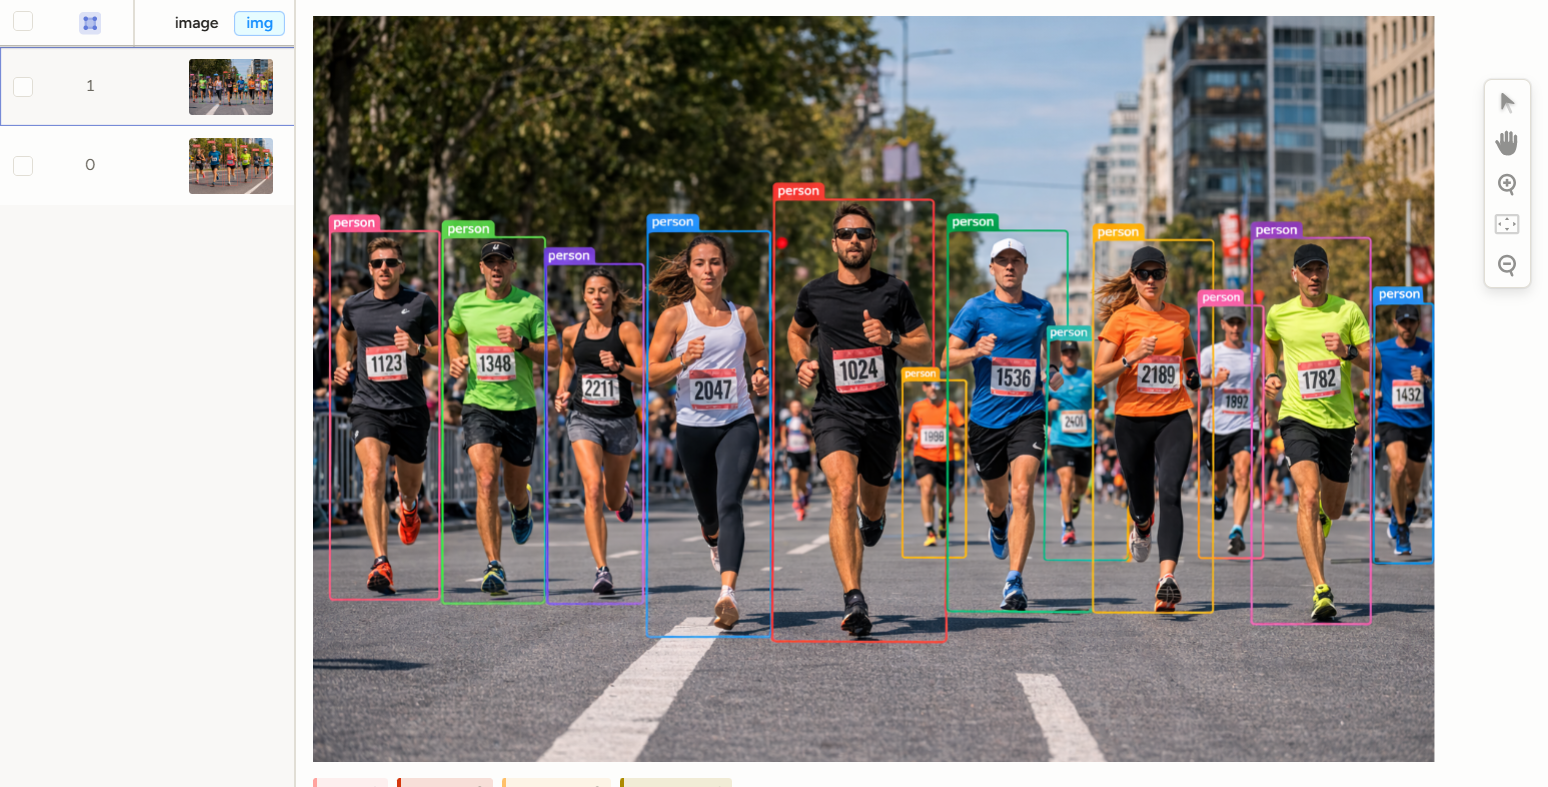
边界框
边界框是物体检测的基本格式。标注员在物体周围绘制一个矩形框,指定其在画面中的位置。当系统需要知道物体存在及其大致位置,而不需要像素级精确轮廓时,这种方法效果很好。
边界框通常用于:
- 检测车辆和道路物体;
- 检测人员;
- 在图像中查找产品;
- 视频监控;
- 物体检测模型的初始训练。
主要优势很明显:快速、可扩展且相对成本较低。缺点也很明显——矩形几乎总是包含额外的背景,因此在复杂形状上的精度有限。
多边形标注
当矩形无法充分描述物体时,使用多边形标注。标注员沿着轮廓手动放置点,形成一个更精确贴合物体形状的多边形。
这种格式用于:
- 医学图像;
- 工业缺陷检测;
- 在卫星图像上标注复杂物体;
- 需要为模型最小化背景噪声的情况。
多边形标注的生产更耗时,但它为模型提供了更清晰的物体几何形状。对于分割和轮廓敏感的任务,这通常不是奢侈,而是要求。
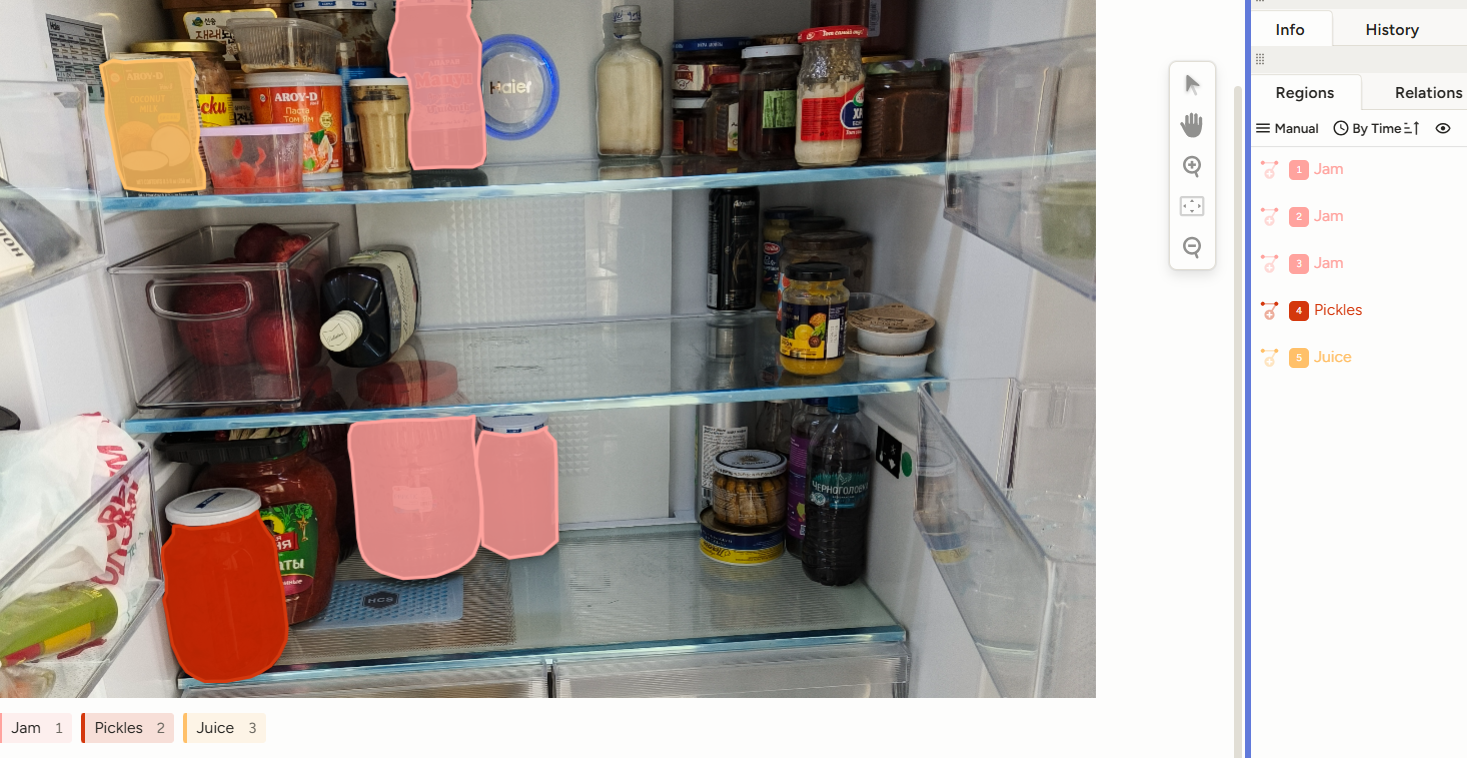
语义分割
语义分割是像素级标注。每个像素都获得一个类别标签,模型开始更深入地理解场景:不仅仅是“这里有一辆车”,而是哪些确切区域属于道路、行人、建筑物或车辆。
这种格式用于:
- 自动驾驶;
- 机器人技术;
- 医学成像;
- 卫星分析;
- 高精度计算机视觉系统。
这是资源最密集的标注类型之一,但当模型需要关于场景的密集信息时,也是最有价值的类型之一。
关键点标注
在许多任务中,系统不需要整个物体,而是其关键点。这些可以是人体骨骼、面部特征点、关节、动物姿态元素或工业部件的特征点。
这种方法用于:
- 姿态估计;
- 动作捕捉;
- 面部分析;
- 运动跟踪;
- 生物力学和体育分析。
有关图像标注格式和支持的数据集结构的更多详细信息,请查看 US-DATA图像标注页面 。
文本标注
文本标注是NLP系统的核心元素:聊天机器人、搜索引擎、工单分类器、推荐系统和LLM流程。在US-DATA主网站上,文本被列为支持的数据格式之一。此方向的专用页面是 文本标注 。
文本分类
最直接的场景是为文本分配一个或多个类别。例如,判断电子邮件是否为垃圾邮件,评估评论的情感,或将文档分类为法律、财务或技术类。
这种标注类型在系统需要快速做出应用决策时使用:路由请求、过滤内容、标记风险消息或按类型分组文档。简单性具有欺骗性:即使是基本的分类也需要清晰的指南,否则模型最终会从不一致的示例中学习。
命名实体识别
NER是文本中命名实体的标注。系统学习突出显示特定的语义元素,而不是整个文档:人名、组织、日期、金额、地点、品牌、合同编号和其他属性。
例如,在句子“Ivan Petrov自2023年以来一直在Yandex工作”中,可以标注PERSON、COMPANY和DATE实体。对于企业系统,这一层至关重要:它支持自动事实提取、关键字段检索以及在非结构化文本之上构建结构化层。
意图标注
意图标注用于对话系统。这里重要的是不仅要理解用户的词语,还要识别他们的意图:下订单、检查配送状态、取消订阅或请求支持。
当意图标注良好时,机器人工作效果显著提高:路由错误更少,用户更快到达所需操作。对于电子商务、金融科技和客户服务,这是最实用的文本标注格式之一。
音频标注
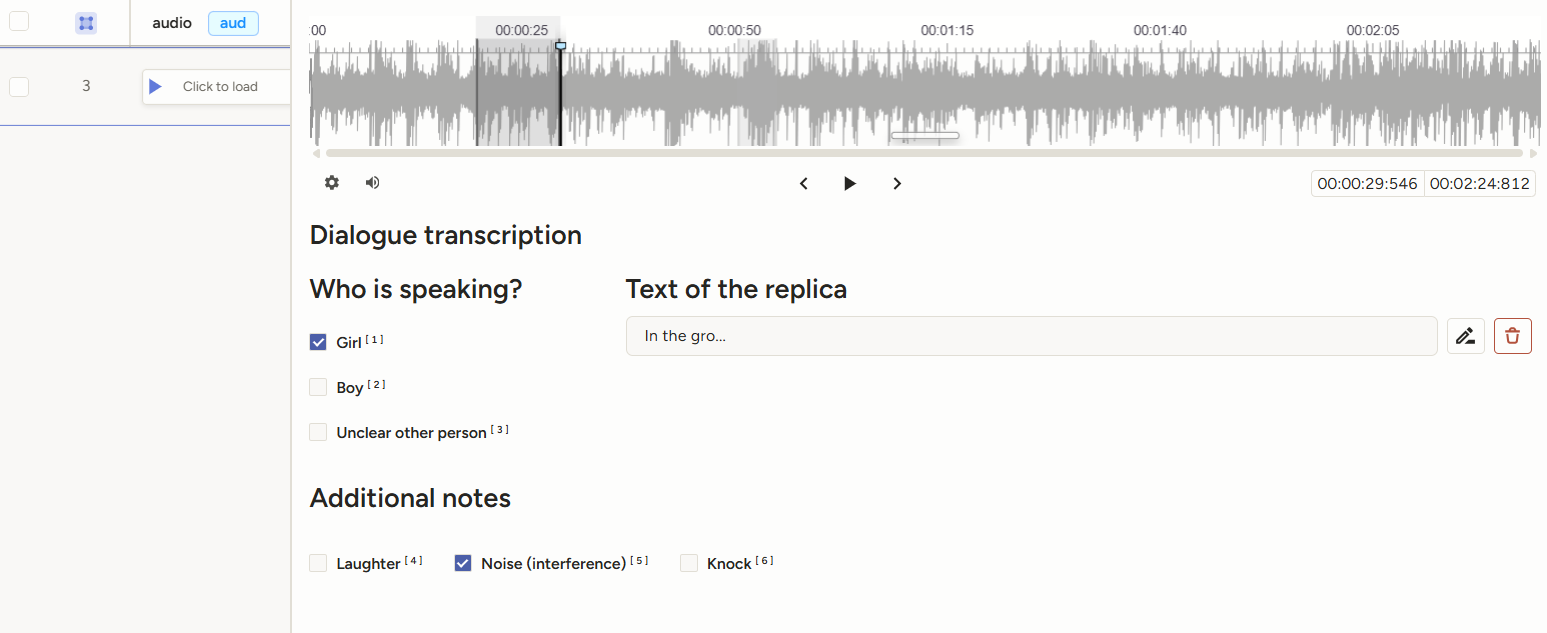
音频标注在模型处理语音、语音界面、通话、播客和多通道录音的任何地方都是必需的。这些服务的详细信息可以在专用 音频标注页面 上找到。
语音转写
音频标注的基本层是转写——将语音转换为文本,通常带有时间戳。此类数据用于语音助手、呼叫中心、字幕系统、语音分析和音频搜索。
如果转写包含错误,所有更高级别的模型——从意图检测到语音分析——都会开始退化。这就是为什么即使是“简单的”语音转文本在实践中也需要严格的指南、质量保证和统一指令。
说话人分离
说话人分离是说话者级别的标注,即跟踪每个时刻谁在说话。在多说话者录音中,没有这一层,模型无法理解对话的结构:话语混合在一起,分析失去准确性。
这种格式对于商务通话、访谈、播客、法庭和官方录音以及对话分析特别有用。
情感标注
另一层是语音中的情感。标注员标记出可听到的烦躁、中性、喜悦、紧张或其他状态的地方。当系统不仅需要分析短语的含义,还需要分析对话的情感背景时,需要这种类型的标注。
视频标注
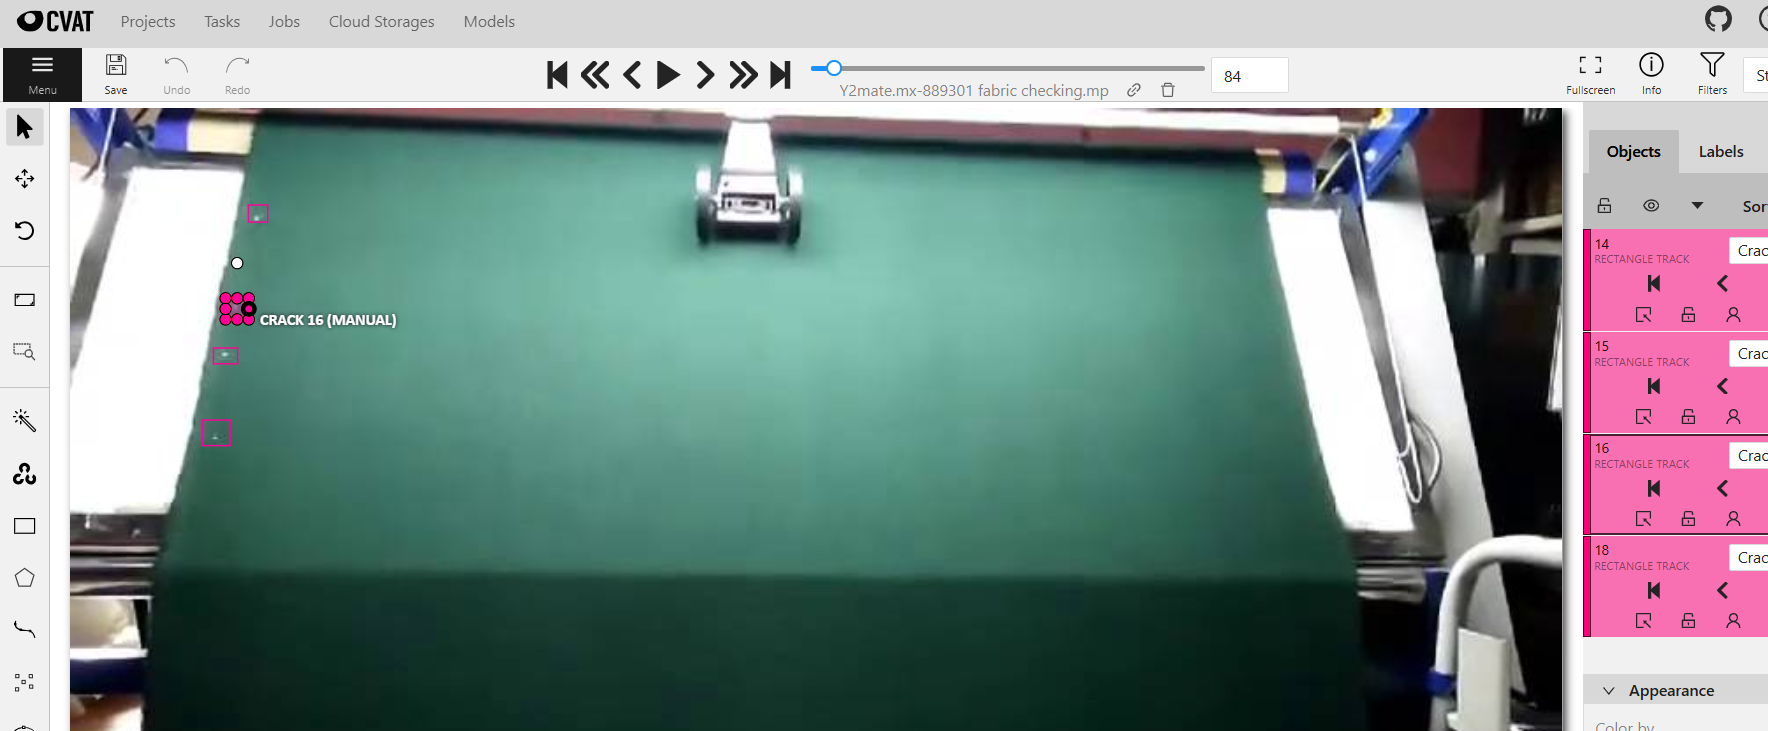
视频标注结合了空间和时间逻辑。仅仅理解画面中的内容是不够的——系统还必须考虑物体如何移动、动作何时开始、场景如何变化以及上下文如何随时间演变。此方向的专用页面可以呈现为 视频标注 。
物体跟踪
物体跟踪是在帧间跟踪物体。模型学习识别同一物体随时间保持其身份,即使视角、光照或部分遮挡发生变化。
跟踪用于视频监控、体育分析、自动驾驶车辆、物流以及监控人流和交通流的系统。
时间分割
时间分割意味着将视频分割成有意义的区间。例如,标注员可以标记动作的开始和结束、场景变化、关键事件、操作阶段或用户场景中的单个步骤。
按执行方法分类的标注类型
标注不仅因数据类型而异,还因生产方式而异。在实践中,使用三种主要方案:手动、半自动和自动。
手动标注
在这里,标注由人工执行,不依赖模型预测。这种方法成本高且速度慢,但对于复杂情况和边缘场景提供了最大的准确性。
优点:
- 高精度;
- 灵活性;
- 正确处理非标准情况。
局限性:
- 高成本;
- 周转时间长;
- 依赖指南质量和质量保证。
半自动标注
在这种方案中,部分工作由算法完成,人工验证和纠正输出。对于大型数据集,当需要加速流程而不显著损失质量时,这是一个最佳选择。
如果项目已经有一个初始模型或预标注系统,可以在人工验证之前用作粗略的第一层,这种方法特别有用。
自动标注
自动标注几乎完全由算法执行。它通常应用于初始标注、处理海量数据或合成数据流程。
然而,没有后续验证,此类数据集的质量很少被认为是生产就绪的。自动标注作为加速器效果很好,但不能完全替代人工输入。
如何选择合适的标注类型
选择同时取决于多个参数,在这个阶段犯错可能会在以后付出高昂代价。
-
项目目标。
如果任务只是检测物体的存在,边界框通常就足够了。如果精确轮廓很重要,最好从一开始就考虑多边形标注或分割。 -
预算。
标注越深入和精确,成本越高——包括人工工作、质量保证和指南准备。 -
精度要求。
对于医疗保健、自动驾驶、工业诊断和其他安全关键领域,粗略标注不可行,因为错误成本太高。 -
数据量。
对于大型数据集,混合设置通常更有效:自动标注后跟人工验证和控制样本。
常见的数据标注陷阱
即使选择了合适的标注类型,如果过程本身组织不善,也不能保证成功。
标注不一致
当不同的标注员以不同方式标注类似情况时,模型会收到矛盾的训练信号。这是质量下降的最常见来源之一。
指南质量差
如果规则模糊,团队会以自己的方式解释模糊情况。结果,标注员之间的差异增加,数据集中的噪声也随之增加。
数据偏差
如果真实使用场景未在数据集中体现,模型在生产中将不稳定。这在稀有类别、“长尾”情况以及非标准的录音、成像或措辞条件下尤其明显。
为什么选择经验丰富的标注合作伙伴很重要
标注提供商不仅仅是外部的“体力劳动”资源。在实践中,它是ML循环的一部分,决定了训练集的样子以及团队达到工作解决方案的速度。
选择供应商时,值得评估:
- 处理不同数据类型的经验;
- 是否存在正式的质量保证流程;
- 团队扩展能力;
- 对ML具体细节的理解;
- 融入客户工作流程的能力;
- 数据存储和处理的安全性。
US-DATA作为数据标注合作伙伴
US-DATA定位为机器学习的数-据标注服务,处理图像、文本、音频和视频。网站还强调了核心任务,如物体检测、分割、关键点和分类。
这对企业来说很方便,原因有二。首先,客户不仅获得“手动标注”,而且获得熟悉标准ML流程和数据集结构的服务。其次,特别强调了测试标注、监督和最终数据集在质量保证后的交付——这对于标注质量直接影响模型指标的项目至关重要。
如需快速访问服务,请使用以下页面:
企业最终获得什么
数据标注不是次要操作,也不仅仅是训练前的机械准备步骤。它是任何AI/ML系统的基础层之一,决定了模型能够多好地看到、区分、分类和解释输入数据。
随着模型变得越来越复杂,它们的数据需求也在增长。今天的好数据集不仅仅是大量的信息,而是精确、一致且管理良好的标注,嵌入到稳健的生产流程中。这正是强大的数据标注合作伙伴创造真正价值的地方。