
引言
近年来,人工智能和机器学习市场经历了重大变革。大量开放数据集、预训练模型和工具的出现,使得解决方案的开发速度得以加快。拥有即用型模型和库的平台给人造成一种印象:数据准备阶段正逐渐失去其重要性。
然而,实施机器学习项目的实践经验却表明情况恰恰相反。尽管模型和数据唾手可得,仍有大量项目面临与质量、准确性以及将解决方案迁移到真实环境能力相关的问题。在大多数情况下,这些问题的根本原因不在于模型架构,而在于数据本身——其质量、相关性和标注的正确性。
数据标注仍然是人工智能系统开发的关键阶段之一,并直接影响最终成果。
什么是数据标注
数据标注是对原始数据进行结构化和丰富化的过程,使其适合训练机器学习模型。本质上,这是将非结构化输入转化为算法可以学习格式的阶段。
对人类而言,解读数据是直观的:图像被感知为一组物体,文本被视为有意义的结构,音频被理解为语音或事件。然而,对于机器学习模型来说,同样的数据只是一组没有语义含义的数字数组。标注充当了人类理解与机器处理之间的桥梁。
标注的主要类型
数据标注应用于各种数据类型和任务:
- 文本数据
- 命名实体识别(NER)——识别名称、日期和组织等实体
- 文本分类——确定类别或情感
- 语义标注——分析含义和结构
- 图像
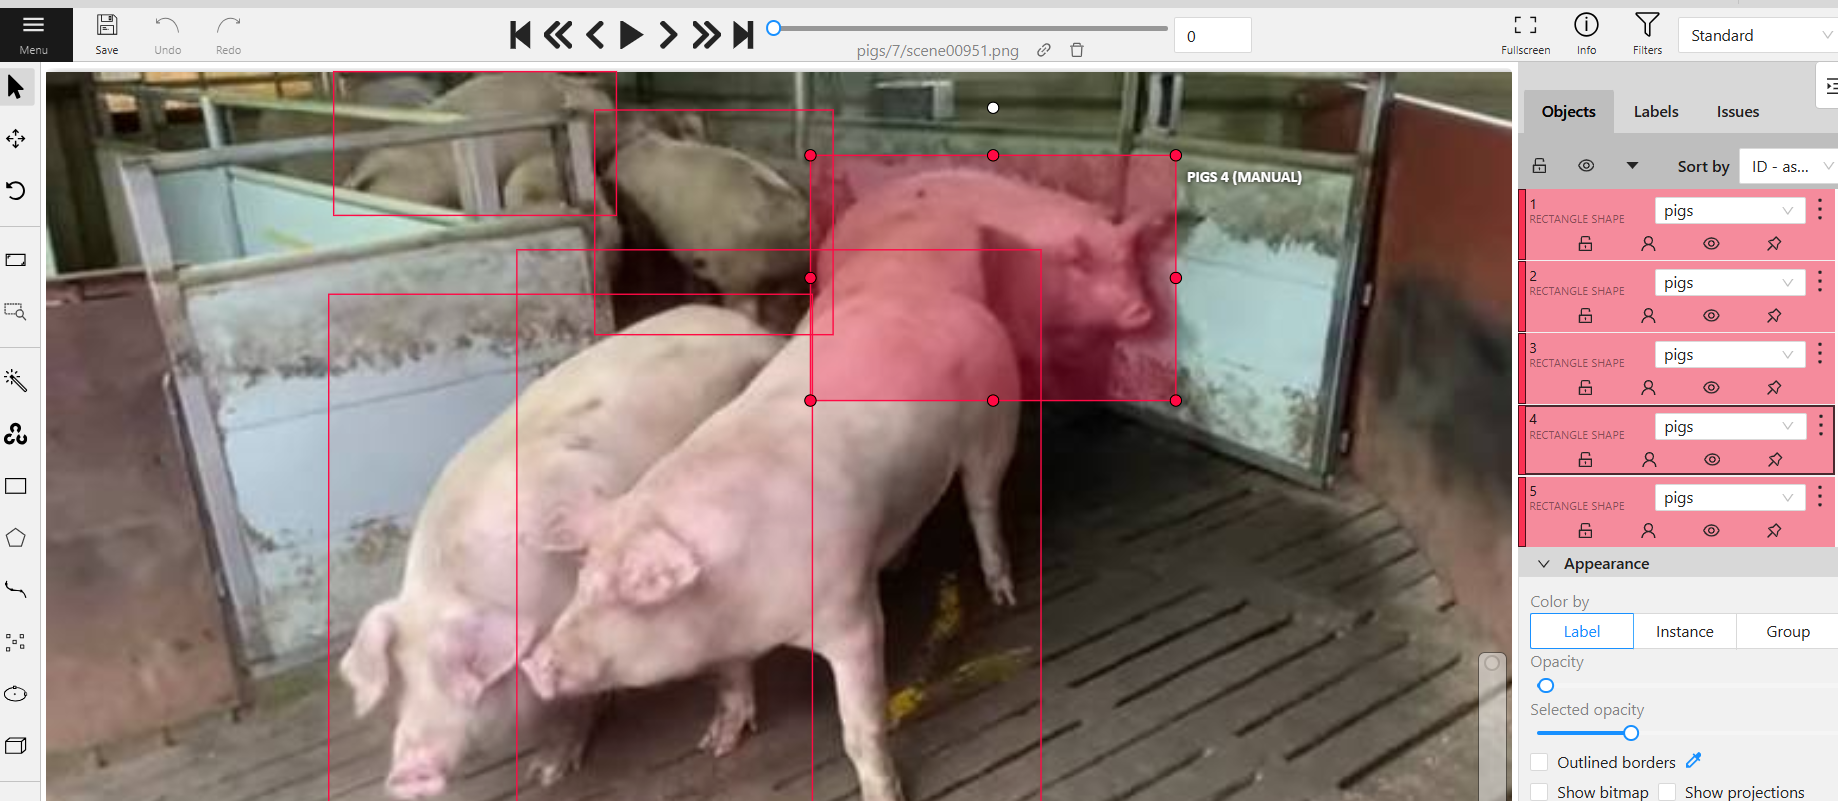
- Bounding Boxes——用矩形标记物体
- 分割——精确的物体边界检测
- 分类——将图像分配到类别
- 视频
- 跨帧物体跟踪
- 场景标注
- 事件检测
- 音频
- 语音转录
- 说话人分离
- 声音分类
- 专业数据
- LiDAR——点云
- DICOM——医学影像
- 地理空间和卫星数据
尽管格式各异,核心思想始终如一:将现实世界的数据转化为结构化信息。
标注在ML流水线中的作用
在典型的机器学习流水线中,有几个关键阶段:数据收集、预处理、标注、模型训练、验证和部署。虽然人们常常关注模型架构或优化技术,但数据准备和标注阶段在很大程度上决定了系统的整体性能。
数据标注在ML流水线中占据核心地位,因为它构成了模型学习解读现实的基础。如果我们将模型视为逼近输入与输出之间关系的函数,那么标注就为这一学习过程提供了“真实标准”。在此阶段引入的任何错误或不一致性都不可避免地会传播到模型的行为中。
与软件代码不同(其中的错误可以系统地识别和修复),数据相关的问题往往是潜在的。标注质量差可能在测试时不会立即显现,但在真实场景中会导致显著的性能下降。
此外,标注不仅影响准确性,还影响鲁棒性和泛化能力。标注规则的不一致性会引入噪声,降低模型的预测能力。
为什么现成数据集不够用
尽管开放数据集和预训练模型广泛可用,但它们在真实业务场景中的应用往往受到限制。主要原因是这些数据集设计为通用型,而实际任务需要针对特定上下文进行调整。
一个关键因素是领域偏移——训练数据与真实数据之间的差异。即使是微小的变化也可能显著影响模型性能。
另一个挑战是数据集结构与业务需求之间的不匹配。实际应用通常需要更详细的分类和上下文感知的标注,而通用数据集无法提供这些。
展示局限性的案例研究
案例1:垃圾分类
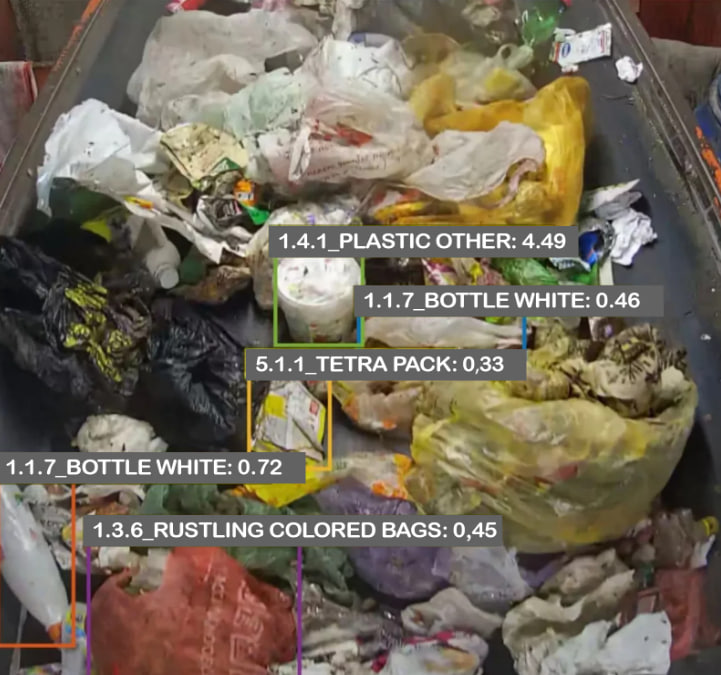
乍一看,垃圾分类似乎是一项简单的任务:识别塑料、玻璃或纸张等材料。然而,在实践中,它要复杂得多。
第一个挑战是类别粒度。实际应用需要区分多种材料类型,例如不同的塑料或纸张类别。这大大增加了类别数量,并使标注和模型训练都变得复杂。
第二个挑战是地理变异性。不同地区的垃圾成分不同,使得在一个地点训练的模型在另一个地点效果不佳。
第三个挑战是物体外观的变异性。垃圾物品通常有破损、脏污或部分遮挡,这增加了检测和分类的难度。
结论:垃圾分类常常被低估。它需要专门的数据集、详细的标注规则和持续更新。
案例2:跨区域车牌识别
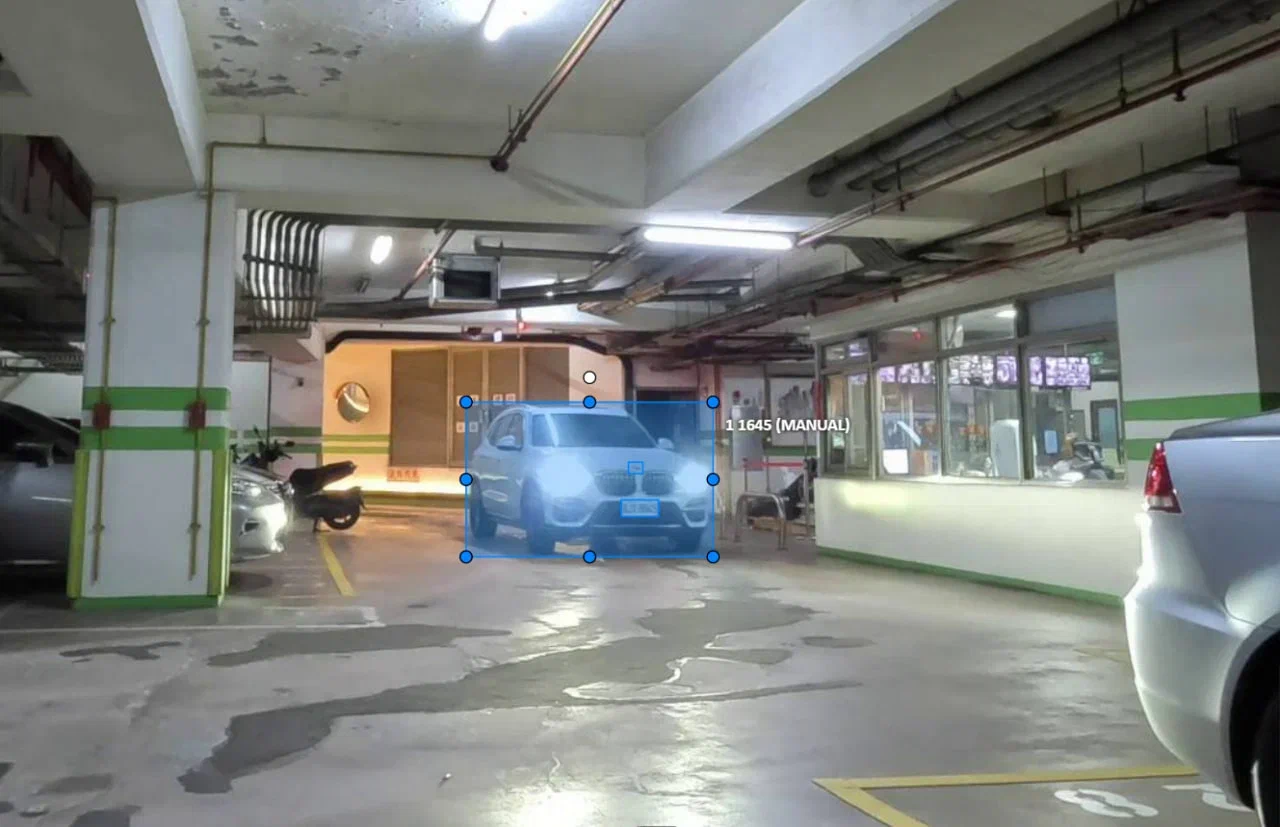
车牌识别被认为是一项成熟的计算机视觉任务。然而,在不同区域之间迁移模型会带来挑战,因为格式、语言和视觉结构存在差异。
差异包括字母表、布局、字体样式以及额外的图形元素。在一个数据集上训练的模型无法有效地泛化到另一个区域。
结论:即使是成熟的任务也需要使用特定区域的数据进行重新训练。
案例3:披萨质量控制
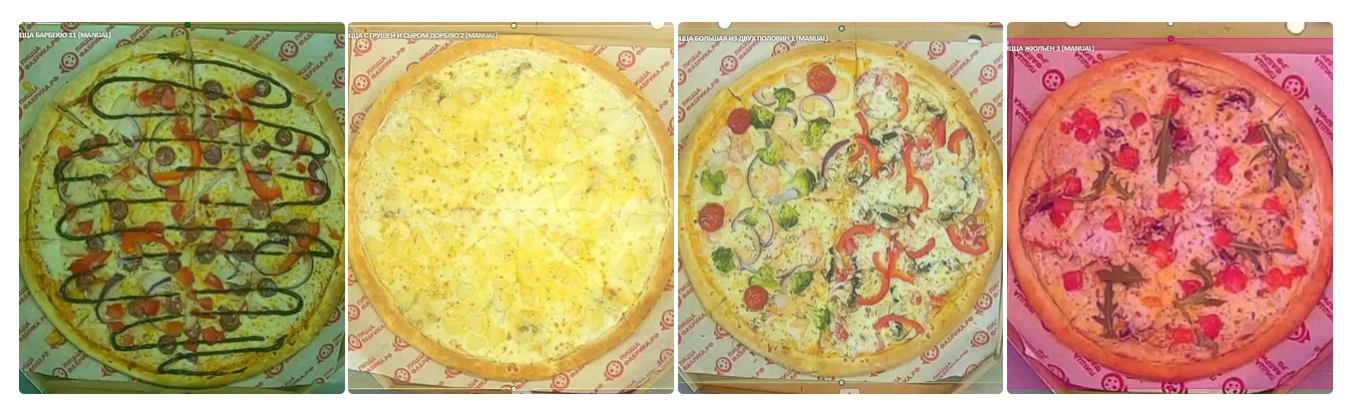
食品生产中的质量控制任务,例如披萨评估,比看起来要复杂得多。
系统必须考虑配料、分布、烘烤质量、颜色、形状和切割精度。包含多种披萨类型的大菜单进一步增加了复杂性。
标注变得多层化,需要领域专业知识。由于配方不断变化,该过程还需要持续更新。
结论:此类任务需要深度适配,不能依赖通用模型。
标注方法
内部团队
提供完全控制,但涉及高成本和管理复杂性。
外包
提供灵活性和成熟的流程,但需要强有力的沟通。
众包
对简单任务有效,但在复杂标注要求下难以应对。
合成数据
合成数据可以在受控条件下生成大量数据。然而,领域差距限制了其在现实世界中的适用性。
标注流程组织
有效的标注流程包括任务定义、指南创建、培训、试点运行、质量控制和规模化。
结论
尽管技术进步,数据标注仍然是机器学习项目的关键因素。数据质量直接影响模型性能,而标注阶段的错误后期难以修复。
如今的竞争优势不仅来自算法,还来自数据的质量。