
1. 为什么数据标注不仅仅是“让人画框”
在现代机器学习和计算机视觉项目中,数据质量已成为模型性能的决定性因素。尽管架构不断进步且预训练解决方案不断涌现,但数据——更准确地说,通过标注对数据的正确解读——才是训练算法的基础。
数据标注是将原始数据(图像、视频、文本)转换为适合模型训练的结构化格式的过程。在计算机视觉任务中,这通常包括:
- 目标定位(Bounding Box)
- 分割
- 关键点检测
- 分类
从理论角度来看,标注充当着训练信号(真实标注)的角色,模型在此基础上构建其内部表示。该信号中的错误或不一致性会直接影响模型的泛化能力和预测准确性。
标注作为生产流程
在实践中,数据标注常被视为一项简单的操作任务。常见的情况是分配一组标注员,让他们“标记数据集”。然而,这种方法忽略了流程的系统性。
更准确的做法是将标注视为一个包含多个相互关联阶段的生产周期:
- 任务形式化与数据需求定义
- 标注指南制定
- 工具设置与配置
- 团队培训与协调
- 质量控制
- 数据准备以集成到ML流水线
每个阶段都会影响最终数据集的质量。任何阶段缺乏标准化或控制薄弱都会导致错误累积,这些错误在模型训练时才会显现。
标注不一致性问题
关键的理论挑战之一是标注一致性。即使任务有正式定义,不同的标注员也可能以不同方式解读。
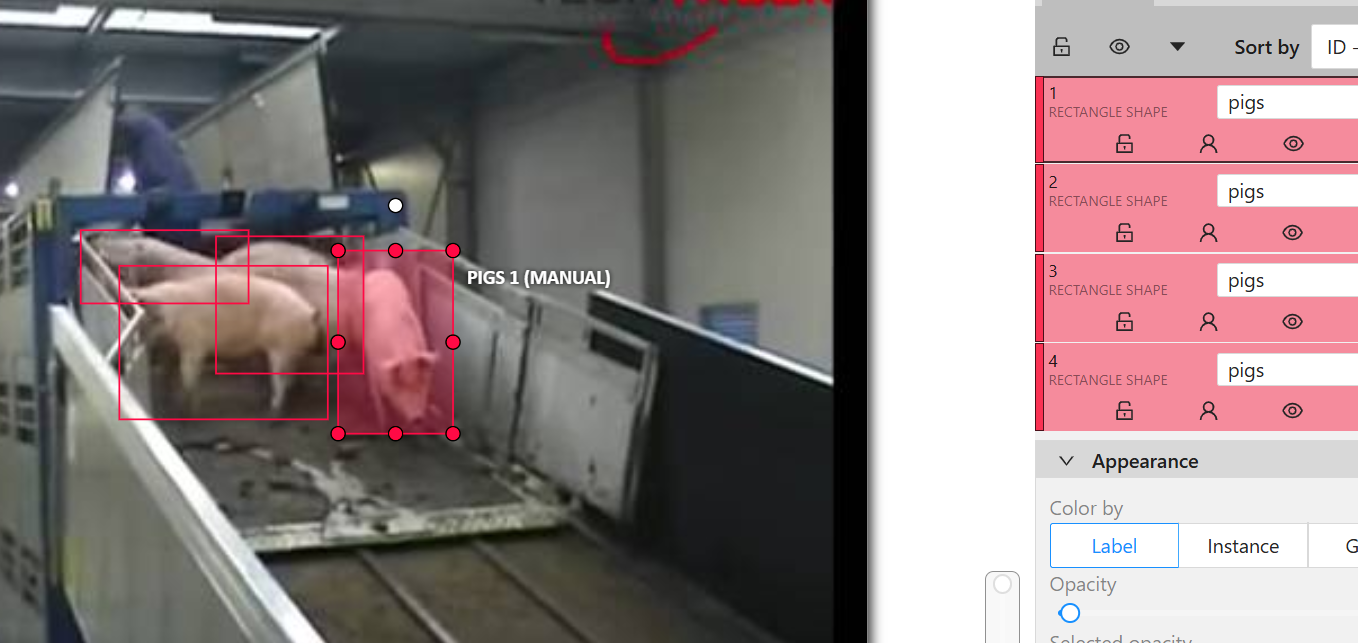
考虑一个检测图像中人物的典型示例。如果没有明确的规则,标注员可能会:
- 在Bounding Box中包含不同的身体部位
- 对部分遮挡的目标处理方式不同
- 忽略较小或模糊的目标
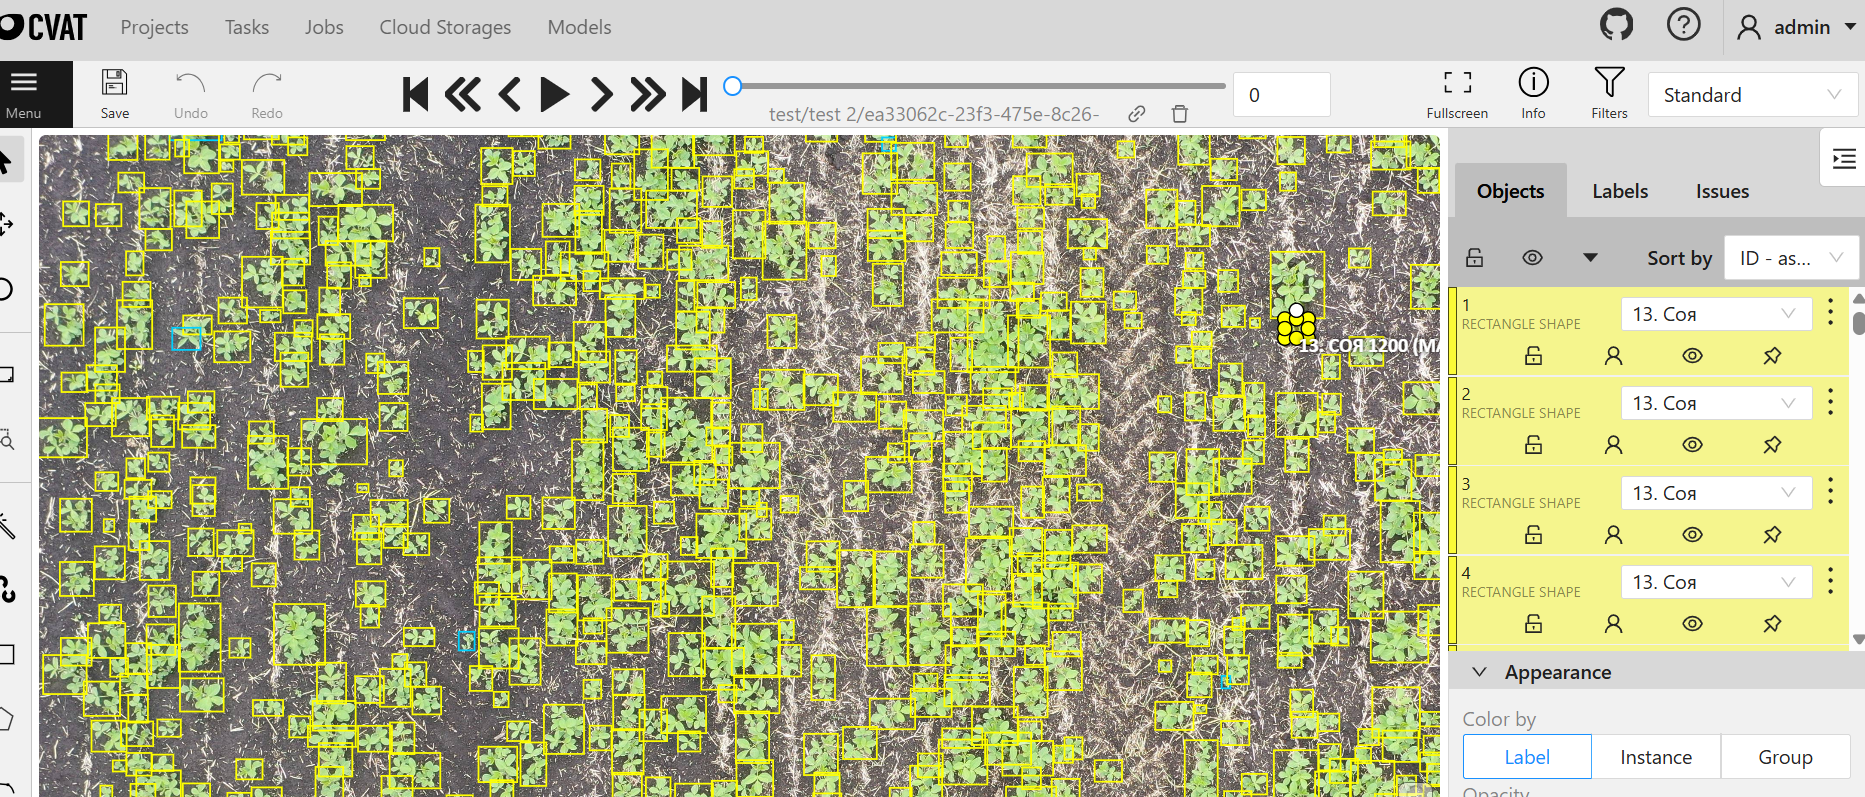
结果导致数据集不一致,同一类别由结构不同的标注表示。对模型而言,这意味着训练信号不稳定,从而降低预测准确性。
工具的作用:能力与局限
CVAT是计算机视觉任务中最广泛使用的数据标注工具之一。它提供图像和视频标注界面,支持多种标注类型,提供基于角色的访问权限,并包含基本的质量控制机制。
然而,重要的是要理解,工具本身并不能解决组织挑战。CVAT不定义标注规则,不确保一致性,如果没有适当的方法论和控制,也无法保证数据质量。
实际复杂性
乍看之下,标注过程似乎是线性的。然而,其背后涉及一系列管理决策——从任务结构化到质量控制和扩展。
结论:数据标注是ML系统的关键组成部分,需要系统化的方法和受管理的基础设施。
2. 标注流程架构:实际运作方式
数据标注不是线性的操作序列,而是一个受管理的生产周期。其关键特征是迭代:数据会返回至先前阶段,指南得到完善,错误得到纠正。
数据准备
原始数据包含噪声:重复文件、损坏文件和无关内容。未经预处理,这会导致质量下降并增加团队工作量。
任务形式化
指南定义了数据应如何解读。没有指南,就会出现不一致,且无法在不重新标注的情况下修复。
标注作为任务流
结构:项目 → 任务 → 作业:
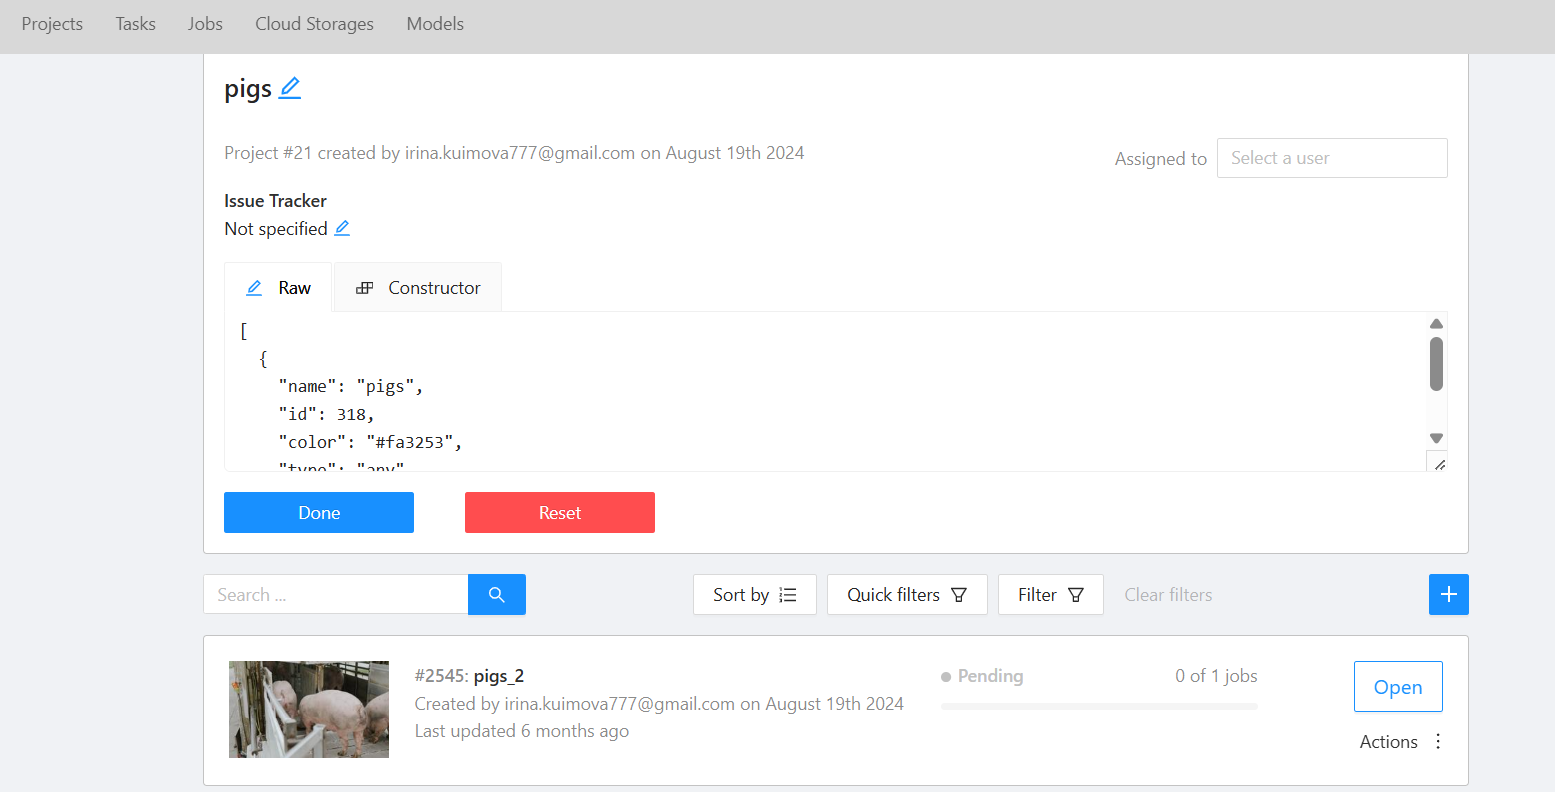
任务必须平衡:过大的任务会拖慢工作,而过小的任务会增加管理开销。
质量控制
质量控制嵌入流程中,通过审查和任务反馈循环持续进行。
导出与训练循环
模型训练后,数据中的错误会显现出来,并反馈回标注流程。
结论:标注是一个具有持续反馈的循环系统。
3. 技术基础设施:服务器、部署与访问
基础设施决定了整个标注系统的稳定性。CVAT是一个多组件应用程序,需要资源并进行适当配置。
服务器要求
- 4–8 vCPU
- 16–32 GB RAM
- SSD(NVMe)
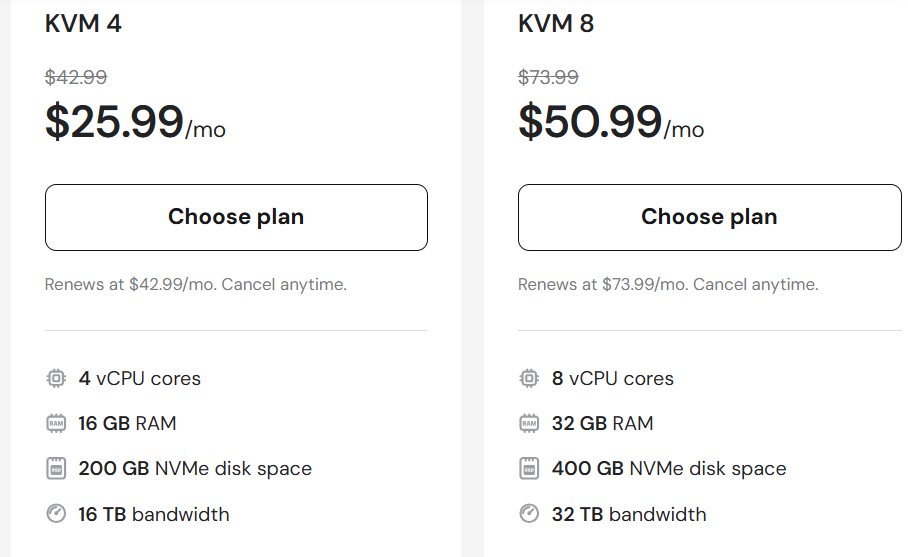
随着团队规模增长,要求也会增加,尤其是在RAM方面。
云端与本地部署
云解决方案可实现快速部署和扩展,但会增加成本。本地基础设施提供控制权,但需要技术专长和维护。
CVAT部署
git clone https://github.com/opencv/cvat
cd cvat
docker compose up -d
这将启动后端、前端、PostgreSQL和Redis。资源不足可能导致容器崩溃。
域名与HTTPS设置
server {
    server_name cvat.yourdomain.com;

    location / {
        proxy_pass http://localhost:8080;
    }

    listen 443 ssl;
    ssl_certificate /etc/letsencrypt/live/cvat/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/cvat/privkey.pem;
}
certbot --nginx -d cvat.yourdomain.com用户与角色
CVAT中的用户管理:
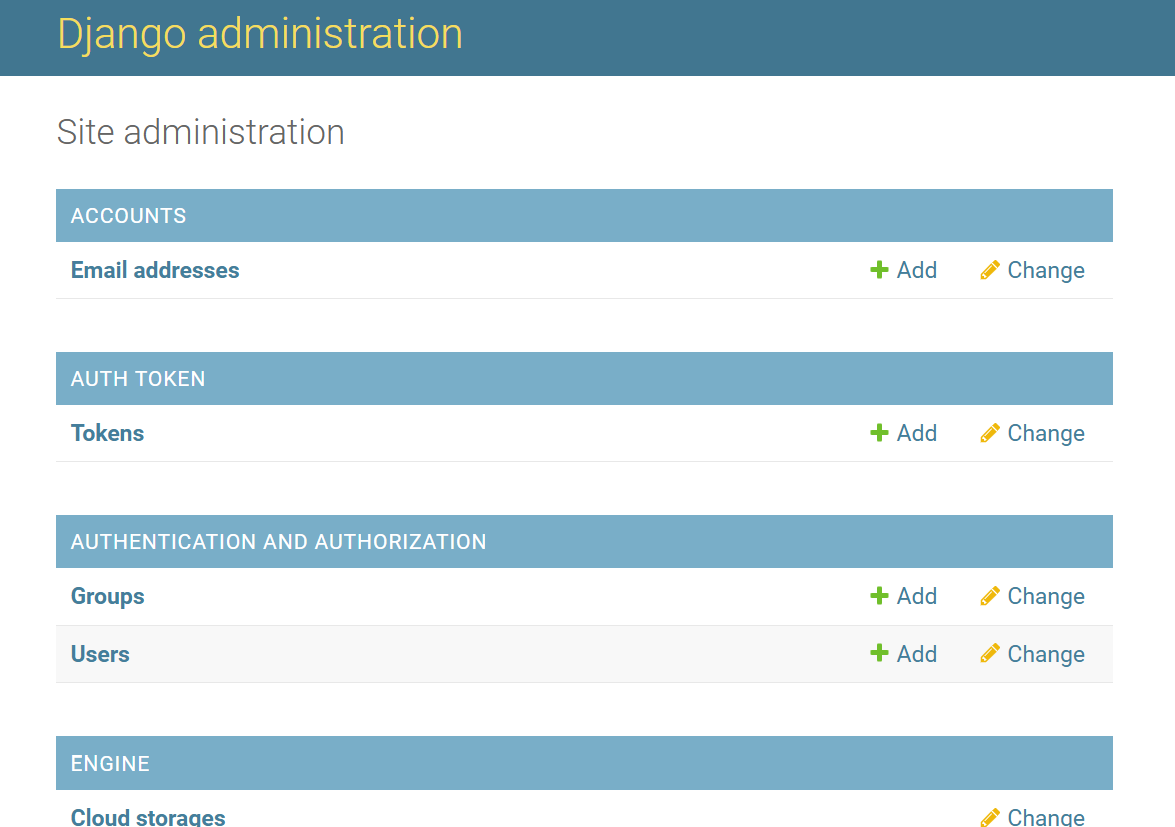
- 管理员
- 标注员
- 审核员
常见问题
- 性能下降
- 磁盘和网络负载
- 更新相关问题
- 需要备份
结论:基础设施是一个独立的职责领域,需要专业知识。
12. 结论:标注是一个系统,而非工具
在CVAT中组织数据标注比乍看之下要复杂得多。在简单的界面背后,是一个多层系统,每个错误都会随着数据量的增加而放大。
标注需要:
- 稳定的基础设施
- 形式化的规则
- 训练有素的团队
- 质量控制
- 迭代方法
在实践中,扩展内部标注常常会导致质量、管理和基础设施方面的问题。
因此,在内部标注与外包之间做出选择,不仅关乎预算,更关乎复杂性的管理。
数据标注是任何模型的基础,其质量决定了最终结果。