
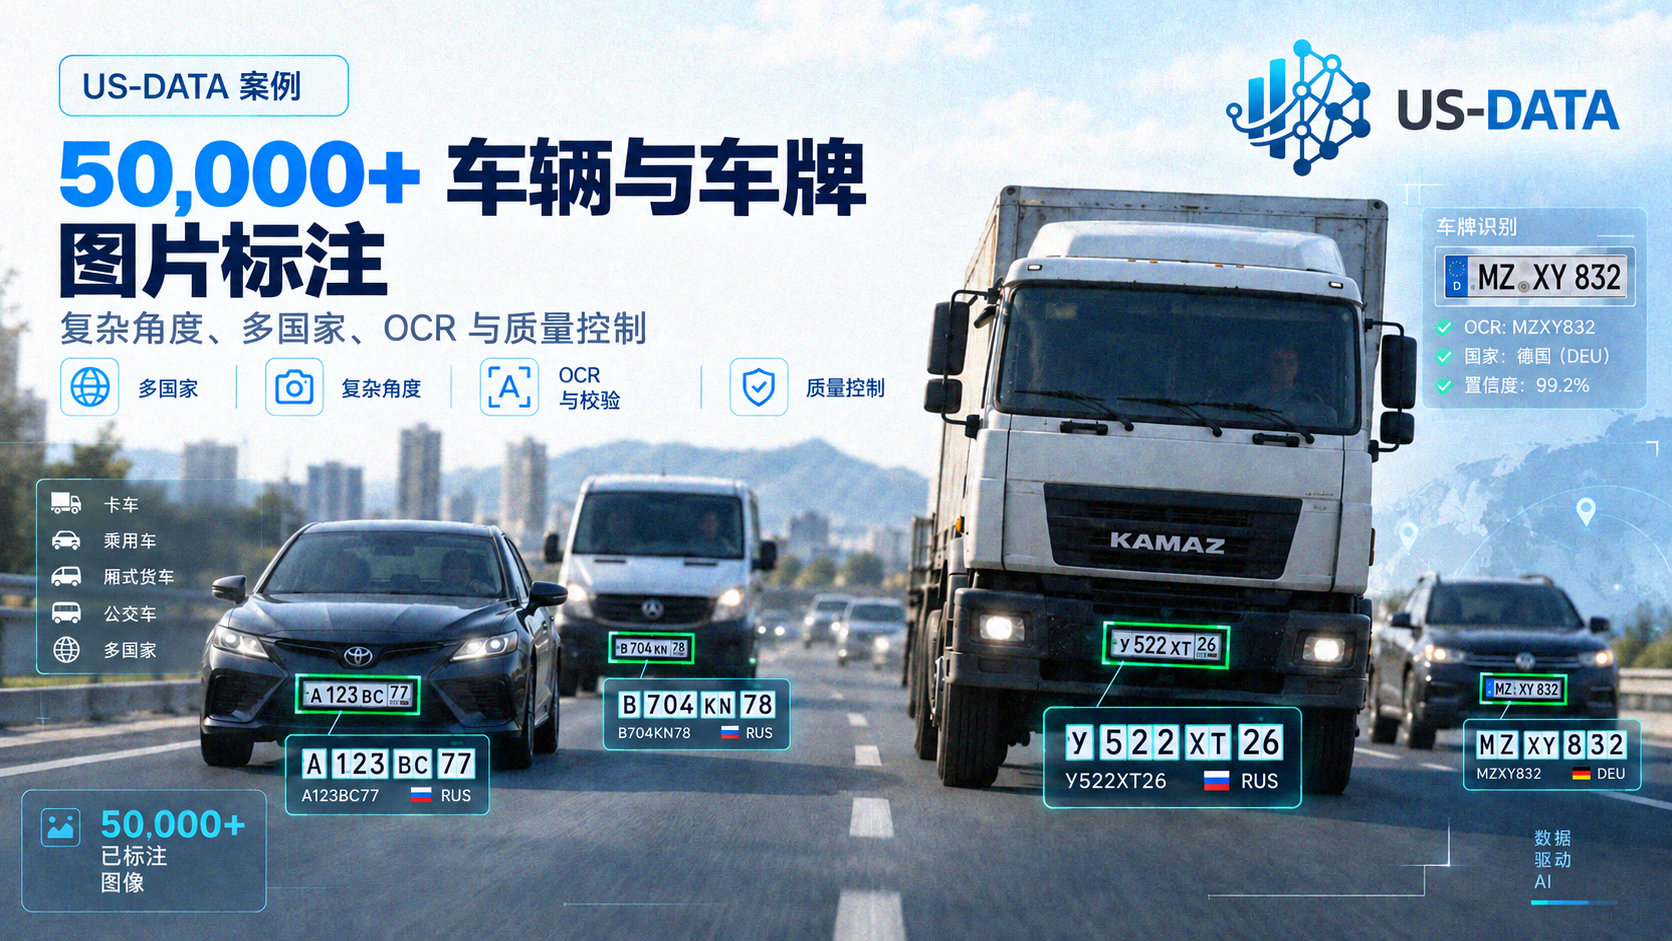
如何为计算机视觉准备一个大规模数据集:一张图片中可能同时出现多辆车,车牌从不同角度拍摄,字符可能被污泥、反光或眩光部分遮挡,而且车辆来自不同国家?本文介绍 US-DATA 为自动车牌识别系统标注 50,000 多张图片的项目。
项目目标
US-DATA 团队收到了一批超过 50,000 张车辆图片,用于为计算机视觉系统准备训练数据集。
模型的任务不仅是检测车辆或车牌。系统还需要学习如何定位图片中的车牌、识别其字符,并考虑与对象相关的其他属性。
该数据集不能按照“每张图片只有一辆车”的方式处理。部分图片中同时出现多辆车辆,因此需要检测并正确描述每一个相关对象。
数据的地域多样性进一步增加了项目难度:样本中包含来自不同国家的车牌,它们在格式、字符排列、国家标识和视觉设计上均存在差异。
需要标注哪些内容
对于每个符合要求的对象,都需要完成多项相互关联的标注操作。
1. 车牌定位
标注员需要确定车牌在图片中的位置,并使用边界框进行标注。这类标注用于训练目标检测模型:算法不仅要判断画面中是否存在车牌,还要准确知道车牌位于何处。
2. 车牌字符转写
车牌上的文字会被转写为结构化文本值。实际上,这一步标注同时为后续 OCR(光学字符识别)准备训练数据。
例如,系统需要学会区分视觉上非常相似的字符,如 С/C、Р/P、У/Y,以及 Y/V、0/O 等组合,尤其是在图片质量较低的情况下。
3. 国家识别
每个车牌都需要标注所属国家。如果车牌上的国家代码存在且清晰可读,则直接使用该信息。
在更复杂的情况下,则需要根据车牌的结构和格式判断其所属国家。
4. 车辆类型识别
此外,还需要对对象进行车辆类型分类,例如乘用车、卡车或摩托车。
因此,一张图片中可能同时包含多个对象,而每个对象又对应多种相互关联的标注类型。
为什么 50,000 张图片并不等于 50,000 个简单任务
图片数量本身并不能反映项目的真实复杂度。
如果一张图片中有三辆车,标注员就需要检测并检查多个对象。如果车牌难以辨认,需要做出的判断和复核也会进一步增加。
因此,在计算机视觉项目中,不应只评估文件数量,还需要考虑对象密度、属性数量以及每张图片的复杂程度。
在这个项目中,以下几类数据最具挑战性。
污损和受损的车牌
真实道路场景中的图片与公开数据集中整洁、清晰的示例差异很大。
车牌上可能出现:
• 泥污;
• 积雪;
• 道路融雪剂和化学残留;
• 磨损;
• 机械损坏;
• 薄膜或其他覆盖物;
• 部分字符几乎消失。
在某些情况下,车牌的一部分在视觉上几乎完全不可见。
对于训练真实环境中的识别系统而言,这类图片尤其有价值,因为模型上线后正会遇到类似情况。
反光、过曝与夜间拍摄
另一项挑战来自光照条件。
车牌的反光表面在白天对人眼而言很容易辨认,但在闪光灯或其他强光源照射下,车牌在图片中可能几乎变成一块纯白区域。
因此,夜间图片需要额外关注。
重要的是明确界限:哪些字符仍然可以可靠读取,哪些情况下继续恢复字符内容就已经变成了猜测。
对于数据集而言,这一点至关重要:标注员不能凭空补充原始数据中客观不存在的信息。
非标准拍摄角度与透视变形
车辆并不总是以正面、标准角度被拍摄。
数据集中包括以下图片:
• 大角度倾斜拍摄;
• 接近地面高度拍摄;
• 俯拍;
• 侧面拍摄;
• 存在明显透视变形;
• 车辆被部分遮挡;
• 车牌距离相机较远。
因此,原本呈矩形的车牌在图片中可能表现为严重变形的四边形,只占画面很小的一部分,或者被车辆部件部分遮挡。
这些样本对模型十分必要,因为未来系统需要在不同摄像机位置和拍摄角度下都能检测到车牌。
西里尔字母与拉丁字母混淆
还有一类错误并不是由图片质量造成,而是来自字符本身。
俄罗斯车牌使用的一些西里尔字母,在视觉上与拉丁字母完全相同或非常相似。当图片分辨率较低时,字符之间的差异会变得非常小。
例如:
С / C
Р / P
У / Y
与此同时,国际数据集中还会同时出现来自不同国家的车牌。
人类可以借助上下文快速判断正确字符,而对模型而言,这类标注的质量会直接决定它是否能够学会区分这些情况。
一张图片中包含多辆车
另一个重要场景是一张图片中同时出现多辆车辆。
在这种画面中,不能只寻找“主要”车辆。需要系统地检查整个场景,确定所有目标对象,并将每个车牌与对应车辆及其属性正确关联。
这使任务从简单的单对象识别,升级为完整的复杂场景计算机视觉标注。
这类图片尤其能体现普通图片分类与专业对象级标注之间的区别。
如何组织大规模数据集标注
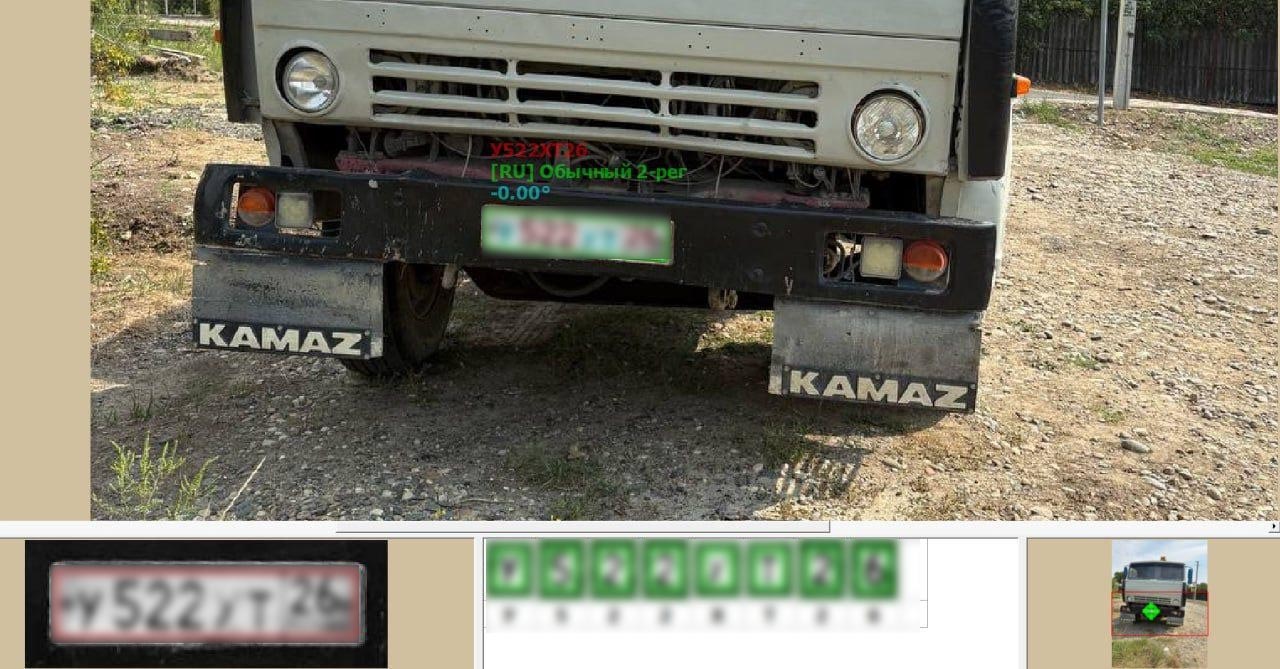
项目扩展时最重要的任务,是确保第 1 张、第 10,000 张和第 50,000 张图片都遵循同一套标注逻辑。
因此,在正式大规模标注开始前,需要建立统一的规则体系。规则中会明确:
• 什么应被视为车牌;
• 如何确定车牌边界;
• 如何处理被部分遮挡的对象;
• 如何处理无法辨认的字符;
• 如何记录存在歧义的情况;
• 如何确定国家;
• 使用哪些车辆类型;
• 在什么情况下需要将图片或对象提交进一步复核。
复杂样本会单独讨论,并转化为供整个团队参考的标准案例。
这样,标注指南可以随着项目推进不断完善,而非标准场景也不会导致同一数据集中出现多套相互矛盾的规则。
质量控制
在大规模项目中,单个标注员的一处错误很容易演变为系统性问题。
如果团队中的一部分人按照一种规则标注同一类车牌,而另一部分人采用另一种规则,神经网络就会收到相互矛盾的训练样本。
因此,本项目采用统一的操作规范,并对标注结果进行额外复核。
以下边界情况会被重点检查:
• 难以辨认的字符;
• 非标准车牌;
• 异常拍摄角度;
• 低质量图片;
• 国家判断存在歧义;
• 同一画面中存在多个对象。
如有必要,争议样本会被单独讨论;确定处理方式后,该样本将作为后续工作的参考案例。
客户最终获得了什么
项目最终交付的是一个由超过 50,000 张已标注图片组成的结构化数据集,可用于后续计算机视觉系统训练。
数据集中整合了多个层级的信息:
图片 → 车辆 → 车牌 → 车牌文本 → 国家 → 车辆类型
这种结构意味着数据并不局限于单一任务。
同一个准备好的数据集可用于训练和测试系统中的多个组件:
• 车牌检测器;
• 字符识别算法;
• 车辆类型分类器;
• 车牌所属国家识别模块;
• 综合自动车牌识别系统。
为什么真实世界数据对车牌识别尤其重要
如果所有车辆都在白天正面拍摄,并且所有车牌都干净、清晰易读,模型很容易在这样的图片集上取得漂亮的结果。
但生产环境完全不同。
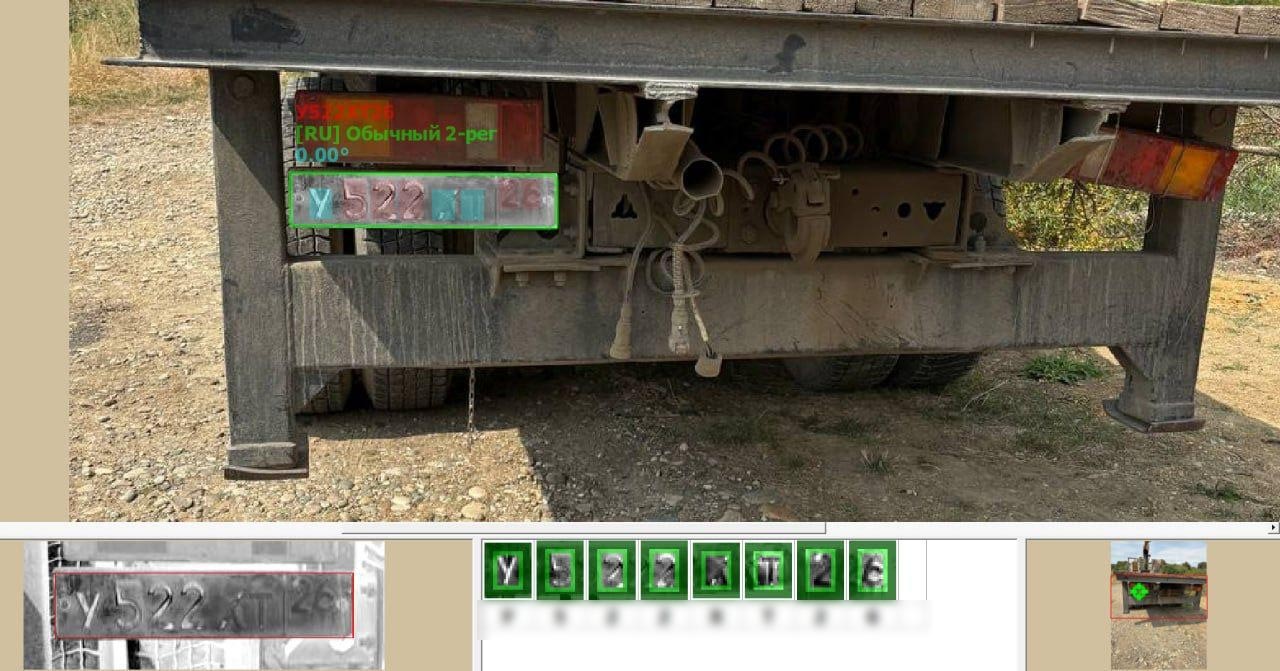
摄像机可能安装得过高或过低;车辆处于运动中;可能下雨或下雪;车牌可能被污染;部分字符处于阴影中;同一画面里可能有多辆车;系统还可能需要在夜间工作。
因此,准备数据集的目标并不是构建一个尽可能“漂亮”的样本集。
恰恰相反,高质量数据集应反映系统部署后会遇到的真实世界多样性。
只有在这样的数据上训练,模型才能不仅在实验环境中表现良好,也能适应实际生产场景。
这类标注适用于哪些项目
车辆与车牌标注可用于以下项目:
• 自动车牌识别(ANPR/ALPR);
• 智能交通系统;
• 出入口管理;
• 停车管理系统;
• 收费公路;
• 城市视频分析;
• 交通监控;
• 物流;
• 安防系统;
• 面向交通基础设施的计算机视觉系统。
从技术角度看,该项目同时结合了多个常见方向:图像标注、目标检测(object detection)、边界框(bounding box)、分类、OCR 标注以及计算机视觉训练数据集准备。
US-DATA:面向复杂计算机视觉任务的图像标注
US-DATA 为计算机视觉系统训练提供图像标注和数据集准备服务,项目规模可从试点批次扩展到数万、数十万甚至更多文件。
我们既可以只负责某一个标注环节,也可以协助搭建完整流程:明确需求、制定标注规则、开展试点、扩展团队并组织质量控制。
真实数据几乎总会包含边界情况。因此,专业标注的目标不仅是快速处理大量文件,更重要的是确保整个数据集在逻辑和标准上保持一致。
类似项目中可使用的服务
• 机器学习数据标注
• 图像目标检测