
Что такое разметка данных и зачем она нужна
Разметка данных — это слой интерпретации между сырыми данными и моделью машинного обучения. Пока изображение, текст, аудиозапись или видеопоток не получили понятную структуру, для алгоритма это всего лишь массив сигналов: пиксели, токены, амплитуды, временные отрезки. Именно разметка превращает этот «сырой поток» в обучающий набор, на котором модель уже может искать закономерности и учиться принимать решения.
Если говорить совсем прямо, разметка сообщает системе, что именно находится перед ней. Не «картинка 1024×768», а автомобиль в такой-то области кадра. Не «строка символов», а пользовательская жалоба, дата, бренд или адрес. Не «аудиофайл на 37 секунд», а речь двух спикеров с паузами, сменой интонации и конкретными репликами. От точности этого слоя зависит очень многое: если обучающие данные описаны небрежно, даже сильная архитектура модели упрется в потолок качества.
Представим задачу детекции автомобилей. Просто загрузить в пайплайн тысячи изображений недостаточно. Для каждого кадра нужно задать, где именно расположен объект, к какому классу он относится, а в ряде сценариев еще и уточнить его форму, ключевые точки или пиксельную маску. Без такой подготовки нейросеть не «видит» автомобиль как сущность — она оперирует только числами без контекста. Поэтому в реальных ML-проектах качество аннотаций часто влияет на итоговый результат не меньше, а иногда и больше, чем выбор архитектуры.
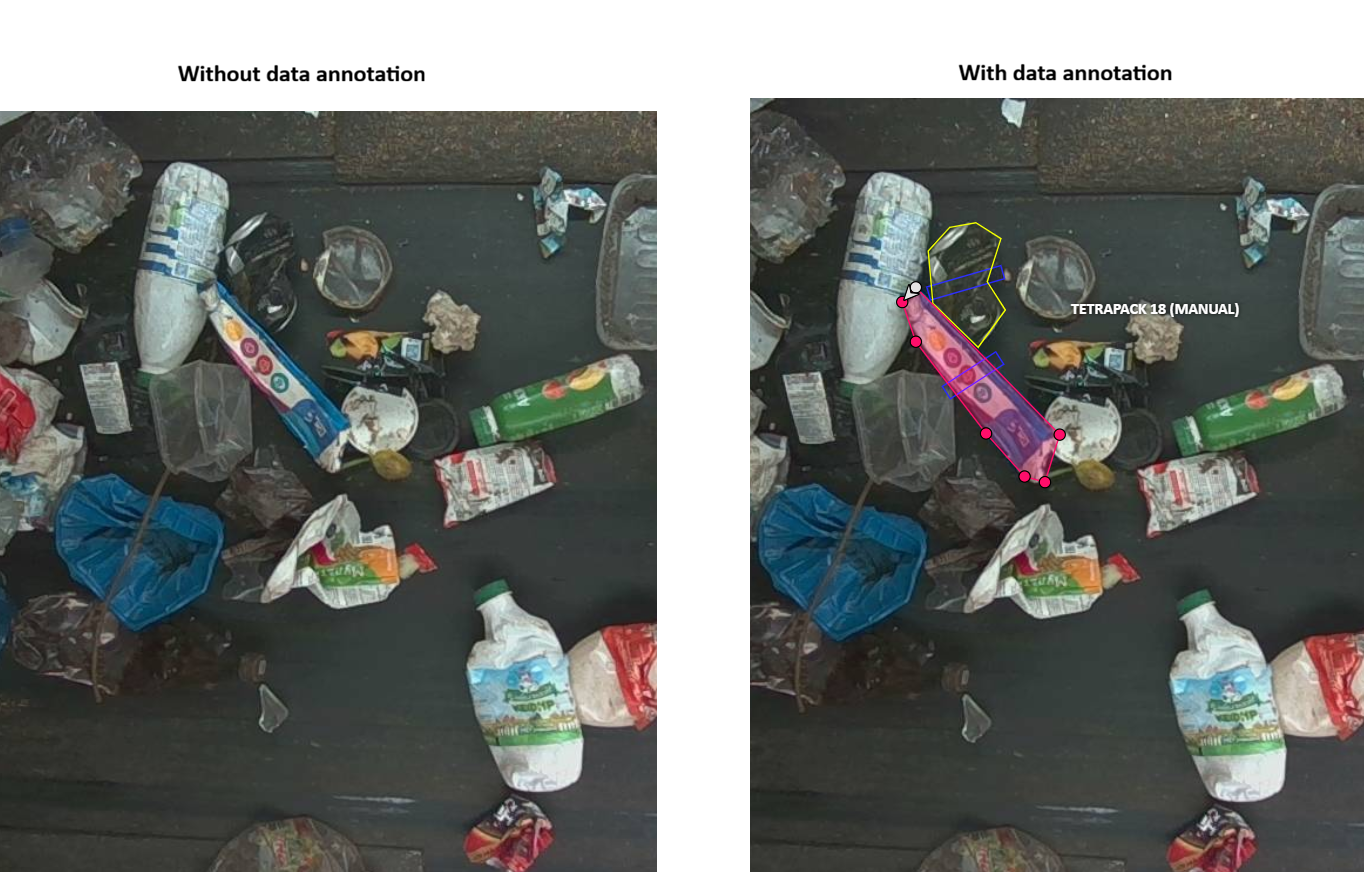
Для задач, связанных с computer vision, отдельные форматы и примеры можно посмотреть на странице разметки изображений .
Основные виды разметки данных
Тип разметки всегда выбирают не «по привычке», а под конкретную ML-задачу, тип данных и допустимую стоимость ошибки. Один и тот же датасет можно размечать по-разному: быстро и грубо — чтобы получить базовую модель, или глубоко и детально — если требуется высокая точность в production-среде.
Обычно разметку делят на четыре больших класса: изображения, текст, аудио и видео. Именно с этими форматами работает US-DATA.
Разметка изображений
Разметка изображений нужна везде, где модель должна понимать визуальную сцену: в системах компьютерного зрения, промышленной аналитике, ритейле, безопасности, транспорте и медтехе. На странице US-DATA по image annotation перечислены ключевые форматы: bounding boxes, полигоны, маски, keypoints, классификация и captioning.
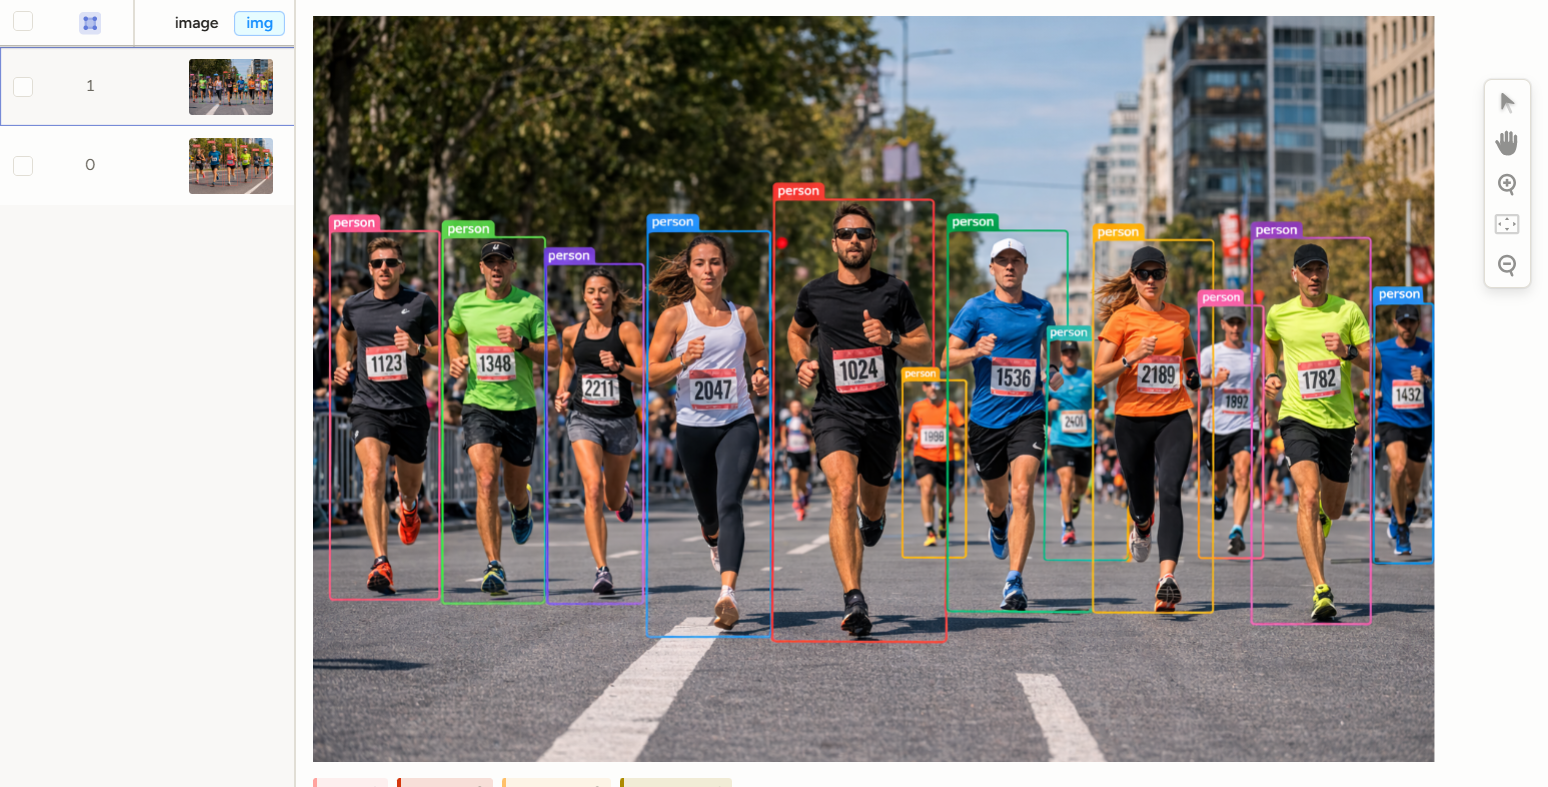
Bounding Boxes
Bounding box — это базовый формат детекции объектов. Разметчик выделяет объект прямоугольной рамкой, задавая его положение в кадре. Такой подход хорошо работает, когда системе важно понять, что объект присутствует и где он расположен приблизительно, без предельной точности по контуру.
Bounding boxes обычно используют для:
- распознавания автомобилей и дорожных объектов;
- детекции людей;
- поиска товаров на фото;
- видеонаблюдения;
- первичного обучения object detection моделей.
Плюс у этого подхода очевидный: он быстрый, масштабируемый и сравнительно недорогой. Минус тоже понятен — прямоугольник почти всегда захватывает лишний фон, поэтому на сложных формах точность ограничена.
Polygon Annotation
Полигональная разметка нужна, когда объект нельзя адекватно описать прямоугольником. Разметчик вручную ставит точки по контуру и получает многоугольник, который повторяет форму объекта значительно точнее.
Такой формат используют:
- на медицинских снимках;
- в промышленном контроле дефектов;
- при разметке сложных объектов на спутниковых изображениях;
- в кейсах, где фон мешает модели и его нужно минимизировать.
Полигональная аннотация дольше в производстве, зато дает модели гораздо более чистую геометрию объекта. Для сегментации и контурных задач это часто не роскошь, а необходимость.
Semantic Segmentation
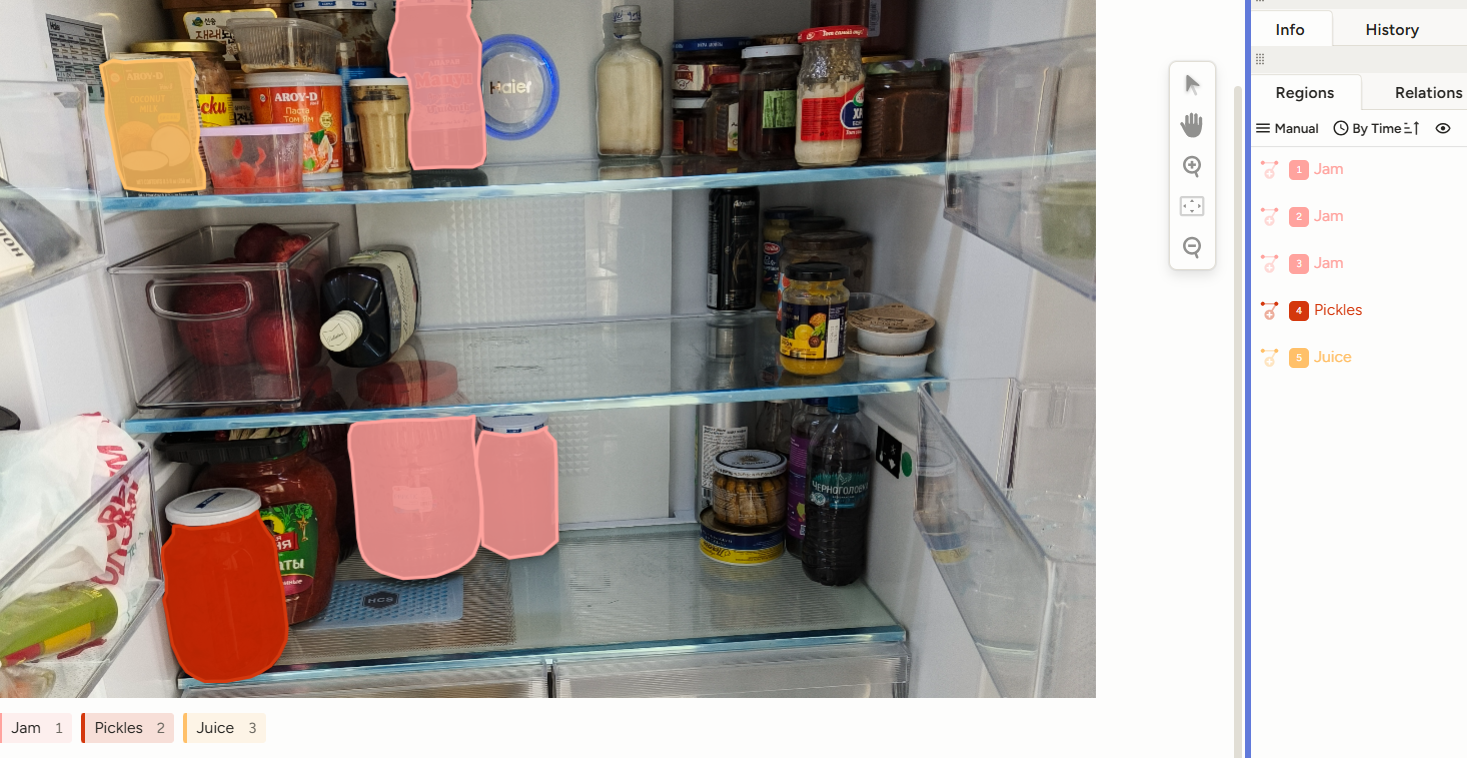
Семантическая сегментация — это разметка на уровне пикселей. Каждый пиксель получает свой класс, и модель начинает понимать сцену значительно глубже: не просто «где-то здесь есть машина», а какие именно области относятся к дороге, пешеходу, зданию или транспортному средству.
Этот формат применяют в:
- автономном транспорте;
- робототехнике;
- медицинской визуализации;
- спутниковой аналитике;
- высокоточных CV-системах.
Это один из самых ресурсоемких типов аннотации, но и один из самых ценных, когда модели нужна плотная информация о сцене.
Key Point Annotation
В ряде задач системе важен не весь объект целиком, а его опорные точки — keypoints. Это может быть скелет человека, точки лица, суставы, элементы позы животного или характерные точки промышленной детали.
Такой подход нужен для:
- pose estimation;
- motion capture;
- face analysis;
- трекинга движений;
- биомеханики и спортивной аналитики.
Подробнее про форматы разметки изображений и поддерживаемые структуры датасетов см. на странице разметки изображений US-DATA .
Разметка текста
Текстовая разметка — базовый элемент для NLP-систем: чат-ботов, поисковых движков, классификаторов обращений, рекомендательных сервисов и LLM-пайплайнов. На основном сайте US-DATA текст указан как один из рабочих форматов данных. Отдельная страница по этому направлению — разметка текста .
Классификация текста
Самый понятный сценарий — присвоить тексту один или несколько классов. Например, определить, является ли письмо спамом, оценить тональность отзыва или отнести документ к юридической, финансовой или технической категории.
Такой тип разметки используют, когда системе нужно быстро принимать прикладное решение: маршрутизировать обращение, фильтровать контент, выделять рискованные сообщения или сортировать документы по типам. Простота здесь обманчива: даже базовая классификация требует четких правил, иначе модель начинает учиться на разнородных и противоречивых примерах.
Named Entity Recognition (NER)
NER — это разметка именованных сущностей внутри текста. Система учится выделять не весь документ целиком, а конкретные смысловые элементы: имена, компании, даты, суммы, географию, бренды, номера договоров и другие атрибуты.
Например, в предложении «Иван Петров работает в Яндексе с 2023 года» можно выделить сущности PERSON, COMPANY и DATE. Для корпоративных систем это критически важный уровень подготовки данных: именно он позволяет автоматизировать поиск фактов, извлечение реквизитов и построение структурированных слоев поверх неструктурированного текста.
Intent Annotation
Intent annotation используют в диалоговых системах. Здесь важно не просто понять слова пользователя, а определить его намерение: оформить заказ, узнать статус доставки, отменить подписку, запросить поддержку.
Если интенты размечены качественно, бот работает заметно точнее: меньше ошибается в маршрутизации и быстрее приводит пользователя к нужному действию. Для e-commerce, финтеха и клиентского сервиса это один из самых практичных форматов текстовой аннотации.
Разметка аудио
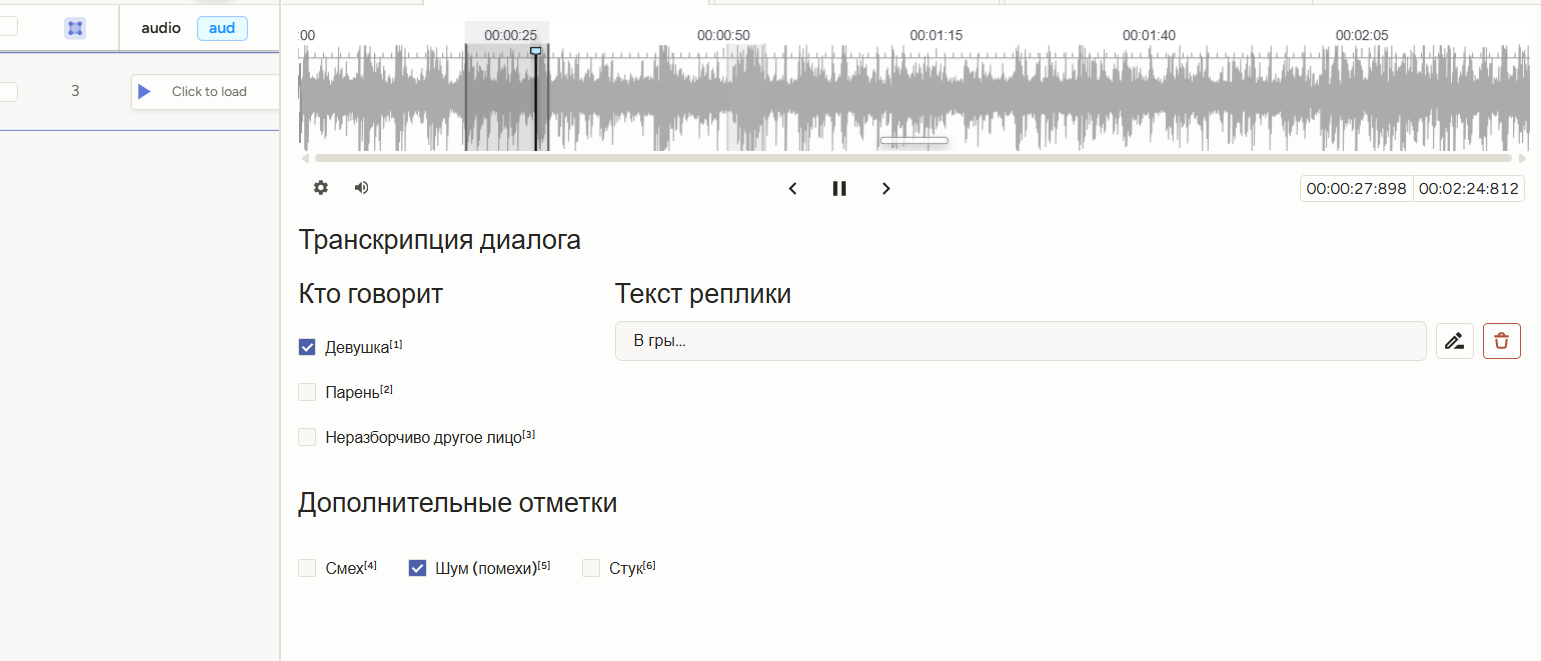
Аудиоразметка нужна там, где модели работают с речью, голосовыми интерфейсами, звонками, подкастами и многоканальными записями. Подробности по услугам можно вынести на профильную страницу разметки аудио .
Транскрибация речи
Базовый слой аудиоразметки — это транскрибация, то есть перевод речи в текст, часто с привязкой ко времени. Такие данные используют голосовые ассистенты, call-центры, системы субтитров, речевая аналитика и поиск по аудиоархивам.
Если транскрипт содержит ошибки, все верхнеуровневые модели — от intent detection до voice analytics — начинают деградировать. Поэтому даже «простая» расшифровка речи на практике требует строгих правил, QA и единых инструкций.
Speaker Diarization
Speaker diarization — это разметка по спикерам, то есть фиксация, кто говорит в каждый момент времени. В многоголосных записях без этого слоя модель не понимает структуру диалога: реплики смешиваются, аналитика теряет точность.
Формат особенно полезен для бизнес-звонков, интервью, подкастов, судебных и служебных записей, переговорной аналитики.
Emotion Annotation
Еще один уровень — эмоции в голосе. Разметчик отмечает, где в речи слышны раздражение, нейтральность, радость, напряжение или другие состояния. Такая аннотация нужна, когда система должна анализировать не только смысл реплики, но и эмоциональный контекст разговора.
Разметка видео
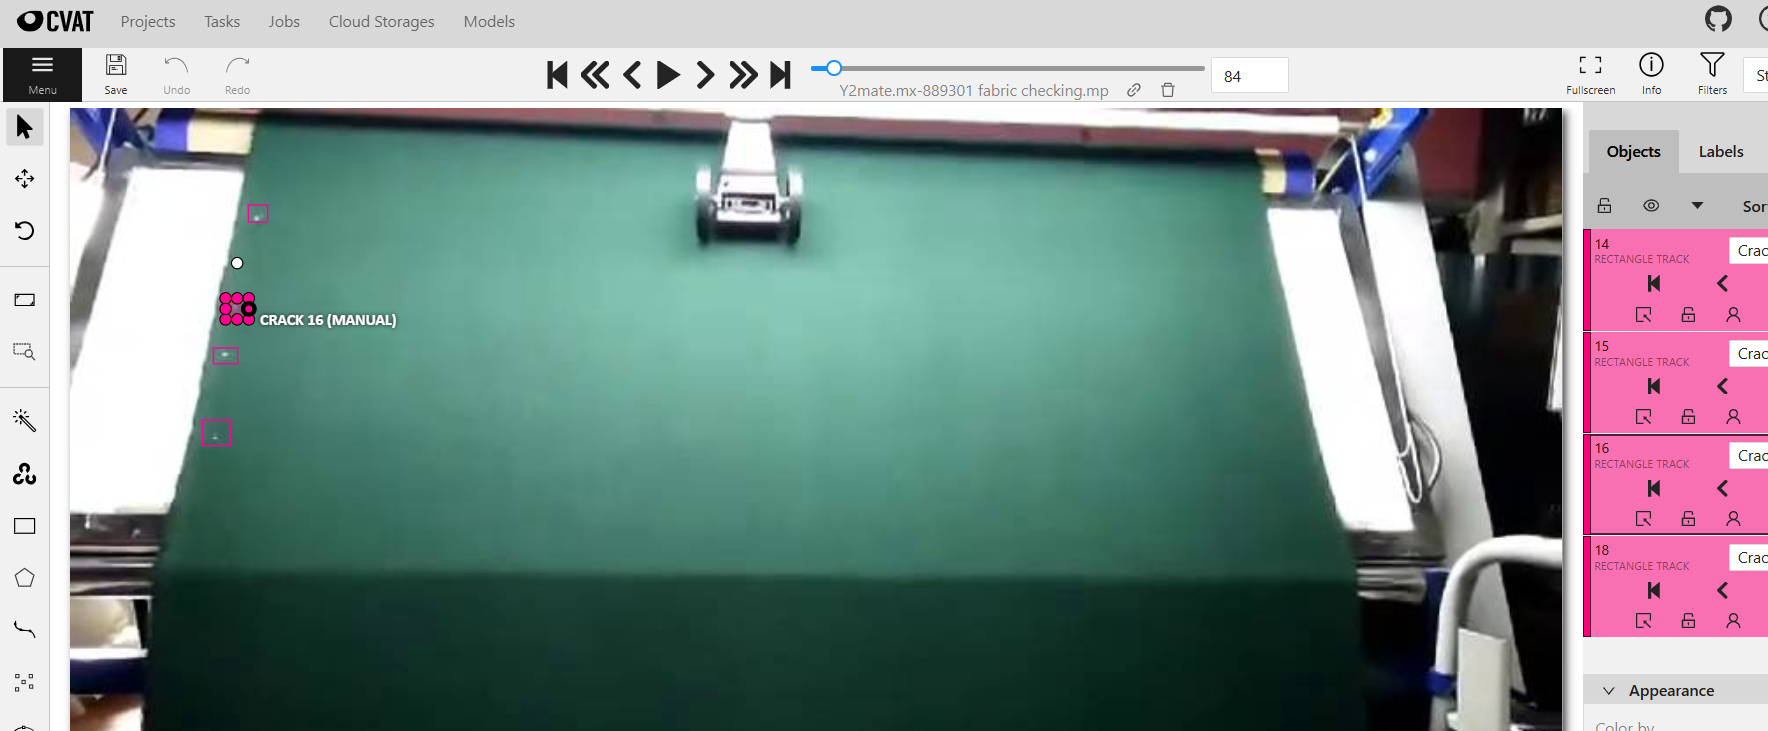
Видеоразметка объединяет пространственную и временную логику. Здесь уже недостаточно понять, что есть в кадре — нужно учитывать, как объект двигается, когда начинается действие, где происходит смена сцены и как меняется контекст во времени. Отдельную страницу под это направление можно оформить как разметка видео .
Object Tracking
Object tracking — это отслеживание объекта между кадрами. Модель учится понимать, что один и тот же объект сохраняет идентичность во времени, даже если меняется ракурс, освещение или частично возникает перекрытие.
Tracking используют в видеонаблюдении, спортивной аналитике, беспилотном транспорте, логистике, системах мониторинга потоков людей и транспорта.
Temporal Segmentation
Temporal segmentation — это деление видео на смысловые интервалы. Например, можно размечать начало и конец действия, смену сцены, появление нужного события, фазу операции или отдельный этап пользовательского сценария.
Виды разметки по способу выполнения
Разметку различают не только по типу данных, но и по тому, как именно она производится. На практике используют три схемы: ручную, полуавтоматическую и автоматическую.
Ручная разметка
Здесь аннотацию выполняет человек без опоры на готовые предсказания модели. Подход дорогой и медленный, но именно он дает максимальную точность на сложных кейсах и edge-сценариях.
Преимущества:
- высокая точность;
- гибкость;
- корректная обработка нестандартных случаев.
Ограничения:
- высокая стоимость;
- длинные сроки;
- зависимость от качества инструкций и контроля.
Полуавтоматическая разметка
В этой схеме часть работы делает алгоритм, а человек проверяет и корректирует результат. Это оптимальный вариант для крупных датасетов, когда нужно ускорить пайплайн без резкого падения качества.
Такой подход особенно полезен, если проект уже имеет стартовую модель или pre-labeling систему, которую можно использовать как черновой слой перед ручной валидацией.
Автоматическая разметка
Автоматическая аннотация строится почти полностью на алгоритмах. Обычно ее применяют для первичной разметки, обработки огромных массивов данных или synthetic data pipeline.
Но без последующей валидации качество такого датасета редко можно считать production-ready. Автоматическая аннотация хороша как ускоритель, а не как универсальная замена человеку.
Как выбрать подходящий тип разметки
Выбор зависит сразу от нескольких параметров, и ошибка на этом этапе потом дорого обходится.
- Цель проекта. Если нужно только определить наличие объекта, часто достаточно bounding boxes. Если важны точные контуры, лучше сразу смотреть в сторону polygon annotation или segmentation.
- Бюджет. Чем глубже и точнее аннотация, тем выше стоимость. Это касается и ручной работы, и QA, и подготовки инструкций.
- Требования к точности. Для медицины, автономного транспорта, промышленной диагностики и других чувствительных областей грубая разметка не подходит — цена ошибки слишком высока.
- Объем данных. На больших датасетах обычно эффективнее работает гибридный сценарий: авторазметка, затем ручная валидация и контрольные выборки.
Типичные ошибки при разметке данных
Даже правильно выбранный тип аннотации не гарантирует результат, если процесс организован слабо.
Неконсистентность разметки
Когда разные аннотаторы размечают одинаковые случаи по-разному, модель получает противоречивый обучающий сигнал. Это один из самых частых источников деградации качества.
Плохие инструкции
Если правила расплывчаты, команда начинает трактовать спорные случаи по-своему. В итоге растет разброс между аннотаторами, а вместе с ним и шум в датасете.
Смещение данных
Если в выборке не представлены реальные сценарии использования, модель будет нестабильна в production. Это особенно заметно в редких классах, длинном хвосте кейсов и нестандартных условиях съемки, записи или формулировок.
Почему бизнесу важно выбирать опытного подрядчика
Подрядчик по разметке — это не просто внешний ресурс «на ручную работу». По сути, это часть ML-контура, от которой зависит, каким будет обучающий набор и насколько быстро команда дойдет до рабочего результата.
При выборе исполнителя стоит оценивать:
- опыт работы с разными типами данных;
- наличие формализованного QA;
- умение масштабировать команду;
- понимание ML-специфики;
- возможность встроиться в клиентский workflow;
- безопасность хранения и обработки данных.
US-DATA как подрядчик по разметке данных
US-DATA позиционирует себя как сервис разметки данных для машинного обучения и указывает, что работает с изображениями, текстом, аудио и видео. На сайте также перечислены технологические направления: object detection, segmentation, landmarks и classification.
Это удобно для бизнеса по двум причинам. Во-первых, заказчик получает не абстрактную «разметку руками», а сервис, знакомый с типовыми форматами ML-пайплайнов и структурой датасетов. Во-вторых, отдельно отмечены тестовая разметка, контроль со стороны супервайзера и выдача готового датасета после финальной проверки, что важно для проектов, где качество аннотаций напрямую влияет на метрики модели.
Для быстрого перехода к услугам можно использовать следующие страницы:
Что в итоге получает бизнес
Разметка данных — это не вспомогательная операция и не механический prep-step перед обучением. Это один из базовых слоев всей AI/ML-системы, который определяет, насколько качественно модель будет видеть, различать, классифицировать и интерпретировать входные данные.
Чем сложнее становятся модели, тем выше требования к данным. Поэтому хороший датасет сегодня — это не просто большой объем информации, а точная, консистентная и управляемая аннотация, встроенная в нормальный производственный процесс. Именно в этом месте и появляется реальная ценность сильного подрядчика по data annotation.