
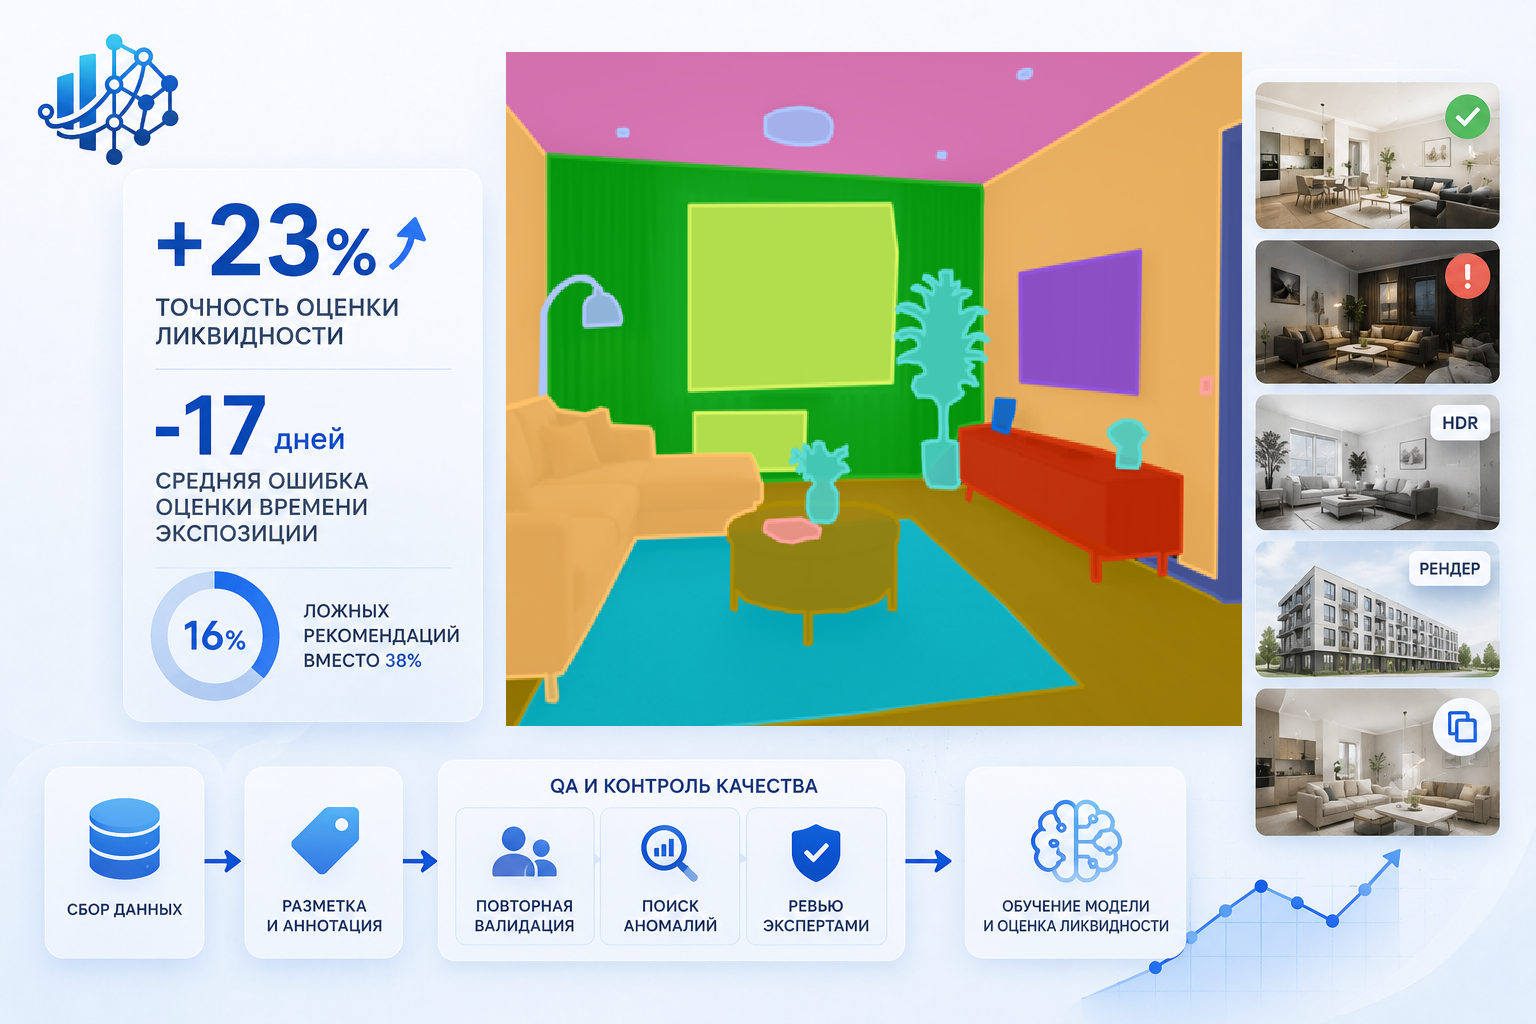
Кейс USDATA: разметка 150 000 фотографий для повышения точности AI-оценки недвижимости
Крупная proptech-платформа столкнулась с проблемой: AI-модель часто ошибалась при оценке ликвидности квартир. Алгоритм учитывал площадь, цену, район и другие параметры, но плохо понимал визуальное состояние объекта по фотографиям.
Например, модель могла считать квартиру более привлекательной из-за хорошего освещения, дорогой люстры или широкоугольной съёмки. При этом реальные признаки, влияющие на интерес покупателей, оставались незамеченными.
Задача проекта
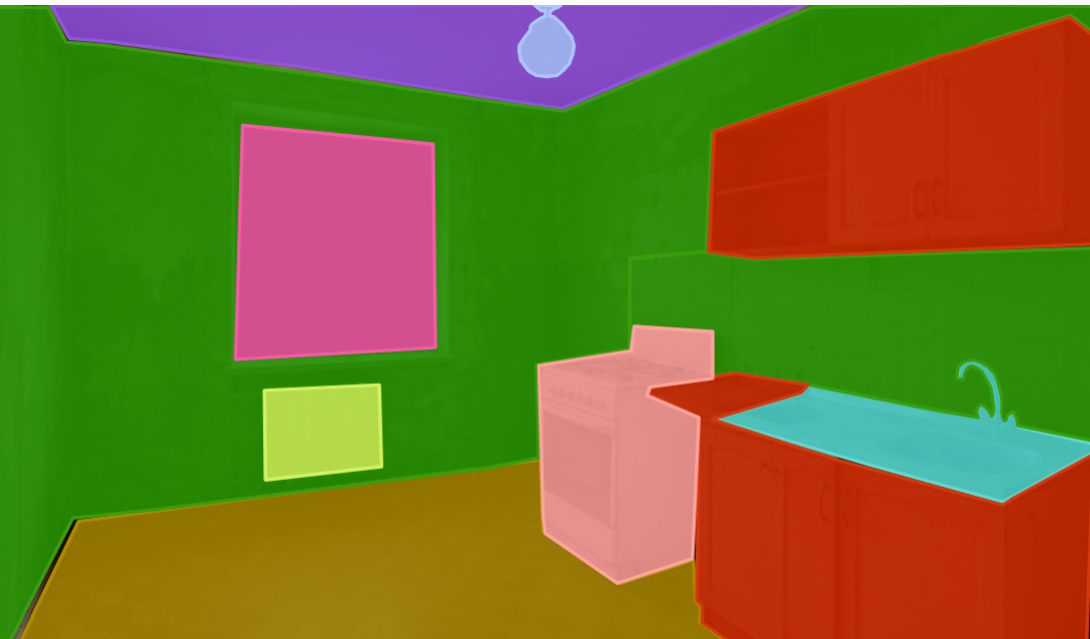
Команде нужно было подготовить качественный датасет изображений, чтобы AI научился лучше оценивать состояние квартиры по фотографиям. Для этого USDATA выполнила разметку изображений с учётом особенностей рынка недвижимости.
Как проходила разметка
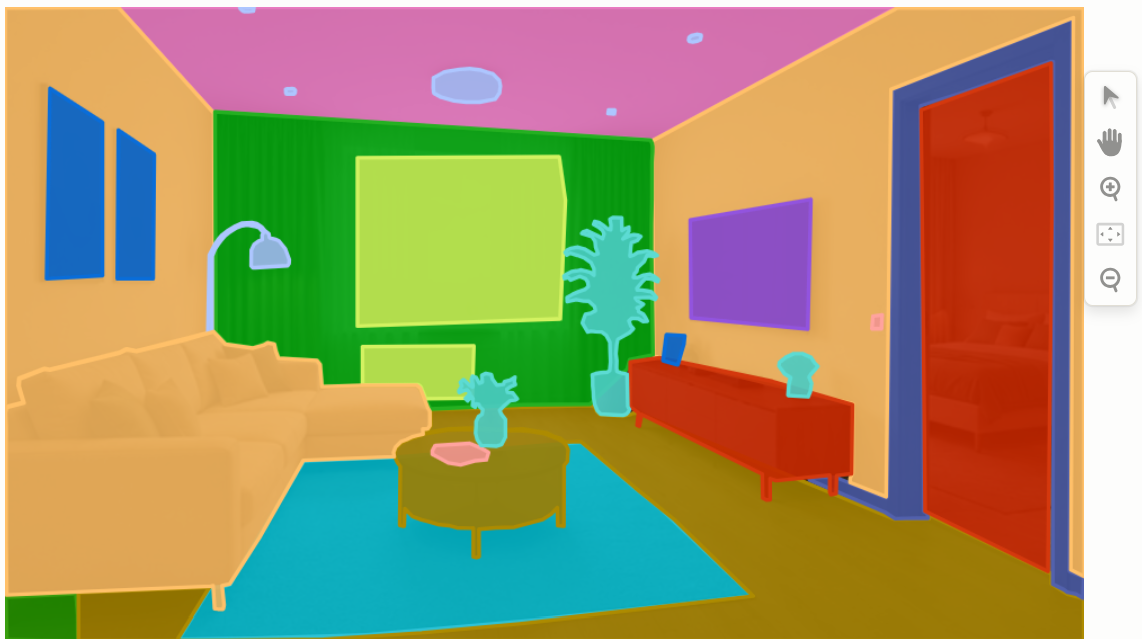
Мы проанализировали десятки тысяч объявлений и выделили визуальные признаки, которые могут влиять на скорость продажи объекта:
- естественное освещение;
- состояние ремонта;
- визуальная чистота помещения;
- ощущение свободного пространства;
- состояние кухни и санузла;
- устаревшая мебель и визуальный шум.
Разметка была построена на двух уровнях. Первый уровень — объекты в кадре: окна, мебель, техника, отделка. Второй уровень — общее восприятие сцены: свет, состояние помещения, аккуратность и простор.
Чтобы разметка была единообразной, мы подготовили подробный гайд для специалистов и внедрили многоступенчатый контроль качества.
Что пришлось доработать
После первой итерации стало понятно, что модель слишком сильно реагирует на качество съёмки. Профессиональные фотографии могли завышать оценку объекта, а плохое освещение — занижать её.
Поэтому мы дополнительно размечали рендеры, HDR-изображения, дубли, кадры с искажениями и другие типы визуальных особенностей. Это помогло отделить реальные характеристики квартиры от особенностей фотографии.
Результат
После обучения на подготовленных данных модель стала точнее оценивать ликвидность объектов:
- точность прогноза выросла на 23%;
- средняя ошибка оценки срока экспозиции снизилась с 45 до 28 дней;
- доля ложных рекомендаций по быстро продаваемым объектам снизилась с 38% до 16%.
Для клиента это означало более точное ранжирование объявлений, эффективное распределение рекламного бюджета и снижение времени работы с неликвидными объектами.
Вывод
В AI-проектах качество данных часто важнее выбора новой архитектуры модели. Если датасет собран и размечен неправильно, алгоритм учится на случайных признаках и делает неточные выводы.
USDATA помогает компаниям готовить датасеты для задач computer vision, NLP и машинного обучения. Мы выполняем разметку изображений, разметку видео, разметку аудио и разметку текста для AI-проектов разного масштаба.