
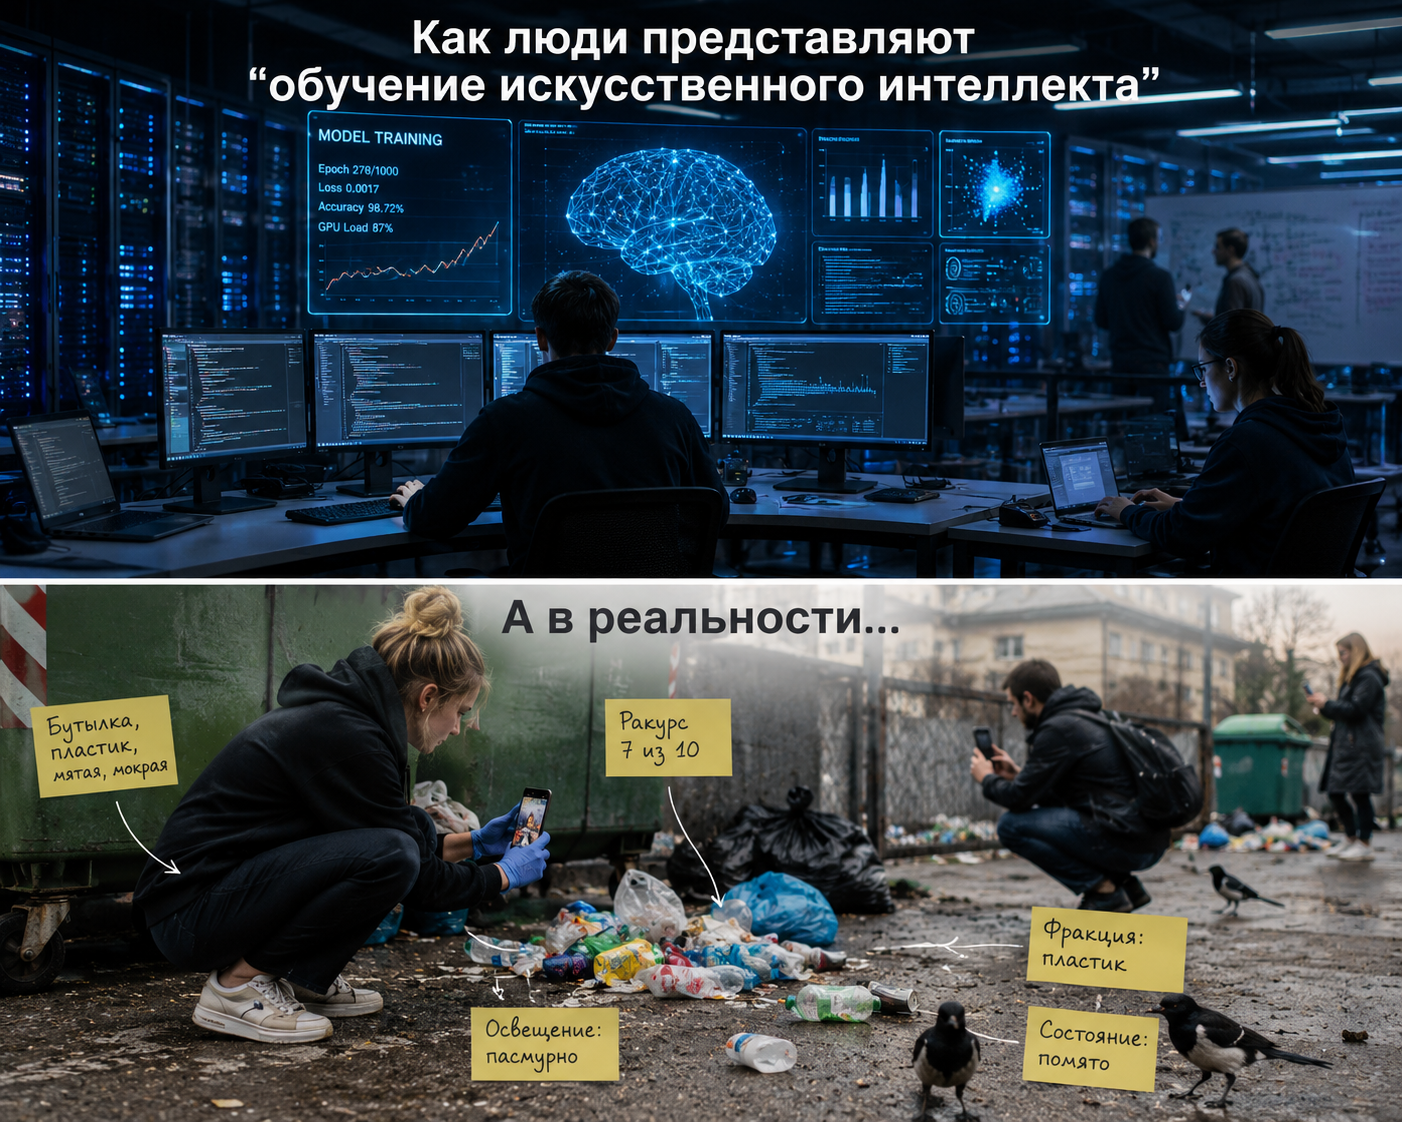
Разметка данных для AI: почему разметчик не всегда работает за компьютером — кейс US-DATA по обучению нейросети для сортировки мусора
Модели компьютерного зрения хорошо работают только тогда, когда обучаются на качественных и релевантных данных. На практике именно данные часто становятся главным ограничением для AI-проектов.
С такой задачей столкнулся проект по автоматизации сортировки отходов. Первоначально нейросеть обучалась на открытых зарубежных датасетах, но при тестировании в российских условиях модель начала ошибаться: не распознавала деформированную упаковку, путала мокрые пакеты со стеклом и плохо определяла объекты в переполненных контейнерах.
Почему готовых данных оказалось недостаточно
Открытые датасеты не учитывали особенности локальной упаковки, загрязнений, освещения, погодных условий и реального состояния отходов. Для модели чистая бутылка из обучающего набора и смятая бутылка после дождя выглядели как разные объекты.
Стало понятно: для корректной работы нейросети нужен новый датасет, собранный в реальных условиях.
Что сделала команда US-DATA
US-DATA организовала полный цикл подготовки данных для обучения модели:
- сбор изображений в городских условиях;
- формирование структуры классов отходов;
- разметку объектов на изображениях;
- контроль качества разметки;
- подготовку датасета для дальнейшего обучения модели.
Проект был сложнее стандартной задачи распознавания объектов. Нейросеть должна была не только определять фракцию отходов, но и учитывать положение предмета в пространстве. Это важно для роботизированной сортировки, где система должна понимать, как объект можно захватить манипулятором.
Как собирался датасет
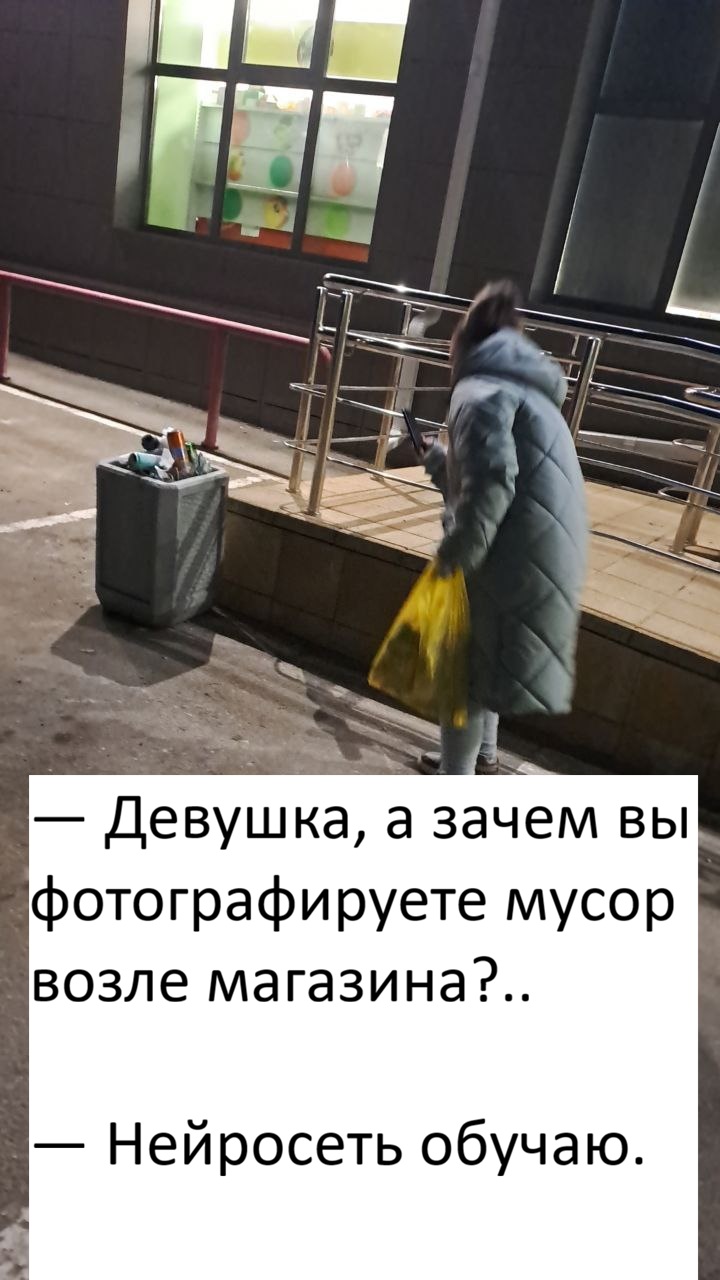
Часть данных пришлось собирать вручную: на контейнерных площадках, возле магазинов и в зонах сбора отходов. Команда фиксировала объекты при разном освещении, степени загрязнения, деформации и наполненности контейнеров.
В датасет вошли разные варианты объектов:
- смятые пластиковые бутылки;
- поврежденные упаковки;
- частично закрытые предметы;
- переполненные контейнеры;
- отходы в сложных погодных условиях.
Результат проекта
В результате был подготовлен специализированный датасет для обучения модели компьютерного зрения, адаптированный под реальные условия эксплуатации. Такой подход помогает повысить точность распознавания и снизить количество ошибок при работе AI-системы вне лабораторных условий.
Подобные проекты востребованы в автоматизированной сортировке отходов, экологическом мониторинге, промышленности и роботизированных комплексах переработки.
Разметка данных для AI-проектов
US-DATA занимается подготовкой и разметкой данных для задач машинного обучения: от компьютерного зрения до обработки текста, аудио и видео. Команда помогает компаниям создавать датасеты, которые подходят не только для тестов, но и для реального применения AI-моделей.
Подробнее об услугах US-DATA: