
Введение
За последние годы рынок искусственного интеллекта и машинного обучения претерпел значительные изменения. Появилось большое количество открытых датасетов, предобученных моделей и инструментов, позволяющих ускорить разработку решений. Платформы с готовыми моделями и библиотеками создают ощущение, что этап подготовки данных постепенно теряет значимость.
Однако практический опыт реализации проектов в области машинного обучения показывает обратное. Несмотря на доступность моделей и данных, значительная часть проектов сталкивается с проблемами качества, точности и переносимости решений в реальную среду. В большинстве случаев корневая причина этих проблем связана не с архитектурой модели, а с данными — их качеством, релевантностью и корректностью разметки.
Разметка данных остаётся одним из ключевых этапов разработки систем искусственного интеллекта и напрямую влияет на конечный результат.
Что такое разметка данных
Разметка данных (data annotation) — это процесс структурирования и обогащения исходных данных с целью их использования для обучения моделей машинного обучения. По сути, это этап, на котором “сырой” неструктурированный сигнал превращается в обучающий материал, пригодный для алгоритмов.
Для человека интерпретация данных происходит интуитивно: изображение воспринимается как набор объектов, текст — как смысловая конструкция, звук — как речь или событие. Для модели машинного обучения эти же данные представляют собой числовые массивы без семантики. Разметка выполняет роль “переводчика” между человеческим восприятием и машинной обработкой.
Основные типы разметки
Разметка данных применяется в различных типах данных и задач:
- Текстовые данные
- Named Entity Recognition (NER) — выделение сущностей (имена, даты, организации)
- Классификация текста — определение категории или тональности
- Семантическая разметка — анализ смысла и структуры
- Изображения
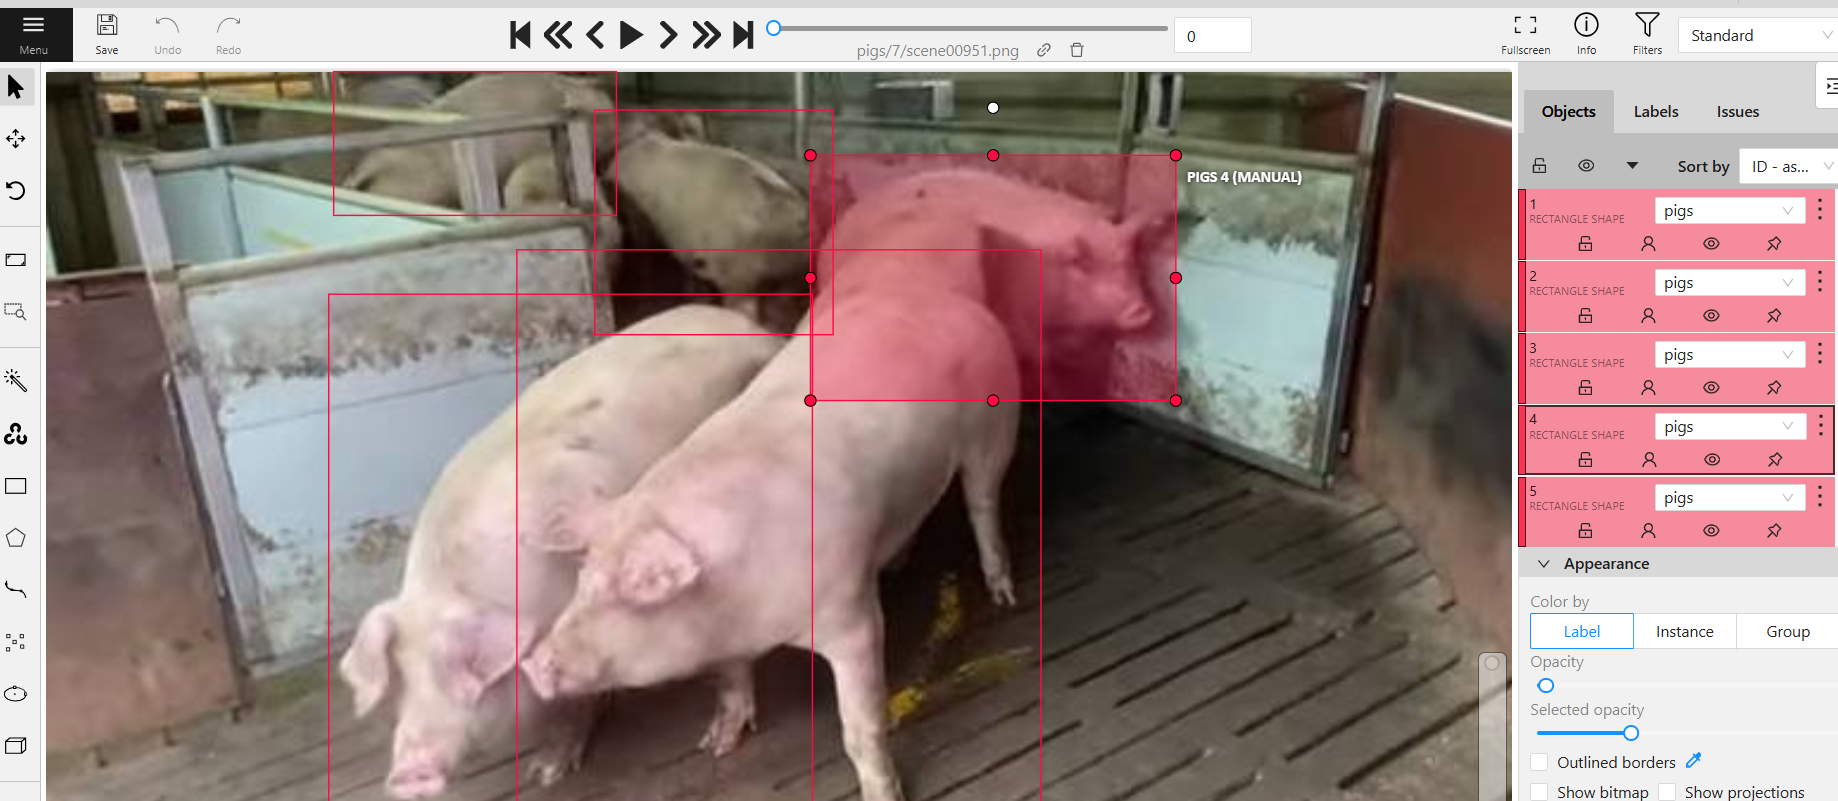
- Bounding boxes — выделение объектов прямоугольниками
- Сегментация — точное выделение границ объектов
- Классификация — определение принадлежности изображения к классу
- Видео
- Трекинг объектов между кадрами
- Сценарная разметка
- Детекция событий
- Аудио
- Транскрипция речи
- Диаризация (разделение спикеров)
- Классификация звуков
- Специализированные данные
- LIDAR — пространственные облака точек
- DICOM — медицинские изображения
- Геоданные и спутниковые снимки
Несмотря на различия в форматах, суть процесса остаётся одинаковой: необходимо формализовать реальность в виде структурированных данных.
Роль разметки в ML pipeline
В классическом процессе разработки решений на основе машинного обучения (ML pipeline) принято выделять несколько ключевых этапов: сбор данных, их очистка и подготовка, разметка, обучение модели, валидация и последующее внедрение в продуктивную среду. Несмотря на то, что внимание часто сосредоточено на выборе архитектуры модели или алгоритмов оптимизации, именно этап подготовки и разметки данных во многом определяет итоговую эффективность всей системы.
Разметка данных занимает центральное положение в ML pipeline, поскольку она формирует основу, на которой модель “учится” интерпретировать реальность. Если рассматривать модель как функцию, аппроксимирующую зависимость между входными данными и целевыми значениями, то разметка выступает источником “истины”, относительно которой происходит обучение. Соответственно, любые ошибки, неточности или неоднозначности, заложенные на этом этапе, неизбежно транслируются в поведение модели.
Важно отметить, что в отличие от программного кода, где ошибки могут быть обнаружены и исправлены с высокой степенью детерминированности, проблемы, связанные с данными, часто носят латентный характер. Некачественная разметка может не проявляться на этапе тестирования, но приводить к деградации качества в реальных условиях эксплуатации.
Кроме того, разметка влияет не только на точность, но и на устойчивость модели, её способность обобщать и корректно работать на новых данных. Непоследовательность в правилах разметки приводит к появлению шума, который снижает предсказательную способность системы.
Почему готовые датасеты не решают задачу
Несмотря на широкую доступность открытых датасетов и предобученных моделей, их применение в реальных бизнес-задачах оказывается существенно ограниченным. Основная причина заключается в том, что такие датасеты создаются как универсальные и обобщённые, тогда как практические задачи требуют высокой степени адаптации к конкретному контексту.
Одним из ключевых факторов является domain shift — различие между данными обучения и данными реальной эксплуатации. Даже незначительные отличия могут приводить к существенному снижению качества модели.
Дополнительную сложность создаёт несоответствие структуры классов и требований бизнеса. В реальных проектах необходима более детализированная классификация и учёт контекста, что невозможно обеспечить с помощью стандартных датасетов.
Кейсы, демонстрирующие ограничения
Кейс 1: Классификация мусора
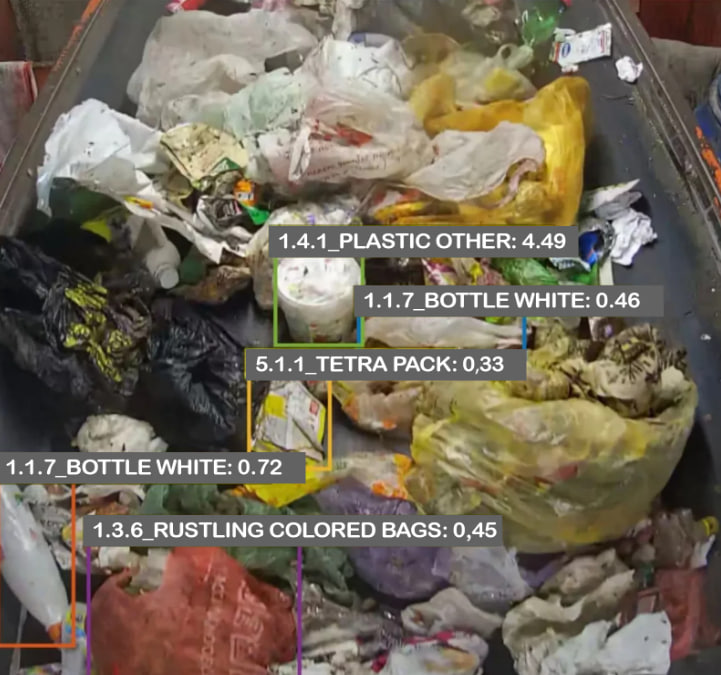
Задача классификации отходов на первый взгляд кажется относительно простой: необходимо определить тип материала — пластик, стекло, бумага или органика. Такой уровень абстракции часто используется в демонстрационных датасетах и прототипах. Однако при переходе к практическому применению становится очевидно, что данная задача обладает значительно более высокой степенью сложности.
Первая проблема связана с детализацией классов. В реальных сценариях укрупнённой классификации недостаточно, так как различные типы материалов требуют раздельной переработки. Например, пластик может включать десятки разновидностей (PET, HDPE, PVC и другие), стекло — отличаться по цвету и составу, а бумага — по типу покрытия и плотности. В результате количество классов быстро увеличивается и может достигать нескольких десятков, что существенно усложняет как разметку, так и последующее обучение модели.
Вторая ключевая сложность — выраженная зависимость от географического контекста. Состав и внешний вид отходов существенно различаются в разных странах и даже регионах. Упаковка, используемая локальными производителями, отличается по форме, материалам и визуальному оформлению. Это приводит к тому, что модель, обученная на данных одного региона, демонстрирует низкую эффективность при применении в другом. Даже при совпадении категорий визуальные признаки могут существенно отличаться.
Третьим фактором является высокая вариативность самих объектов. Отходы редко представлены в “идеальном” виде: они могут быть деформированы, загрязнены, частично перекрыты другими объектами или находиться в сложных условиях освещения. Это затрудняет как детекцию, так и классификацию, требуя более сложных подходов к разметке и расширения обучающего набора.
С точки зрения разметки задача также становится нетривиальной. Необходимо не только определить класс объекта, но и корректно выделить его границы, учитывать частично видимые элементы и соблюдать строгую консистентность между разметчиками. При увеличении количества классов возрастает вероятность ошибок и неоднозначных интерпретаций, что требует разработки подробных гайдлайнов и внедрения многоуровневого контроля качества.
Дополнительную сложность создаёт необходимость постоянного обновления данных. Появляются новые виды упаковки, изменяются стандарты переработки, добавляются новые категории. Это приводит к тому, что датасет и модель требуют регулярного обновления и дообучения, превращая проект в непрерывный процесс.
В результате задача, которая на начальном этапе воспринимается как простая классификация, трансформируется в сложную систему, требующую значительных ресурсов на сбор данных, разметку, контроль качества и поддержку.
Вывод: классификация отходов является примером задачи, где реальная сложность существенно недооценивается. Увеличение числа классов, региональные различия и высокая вариативность данных делают невозможным использование универсальных решений. Для достижения стабильного качества требуется специализированный датасет, строгие правила разметки и постоянная адаптация модели к изменяющимся условиям.
Кейс 2: Распознавание автомобильных номеров в разных регионах
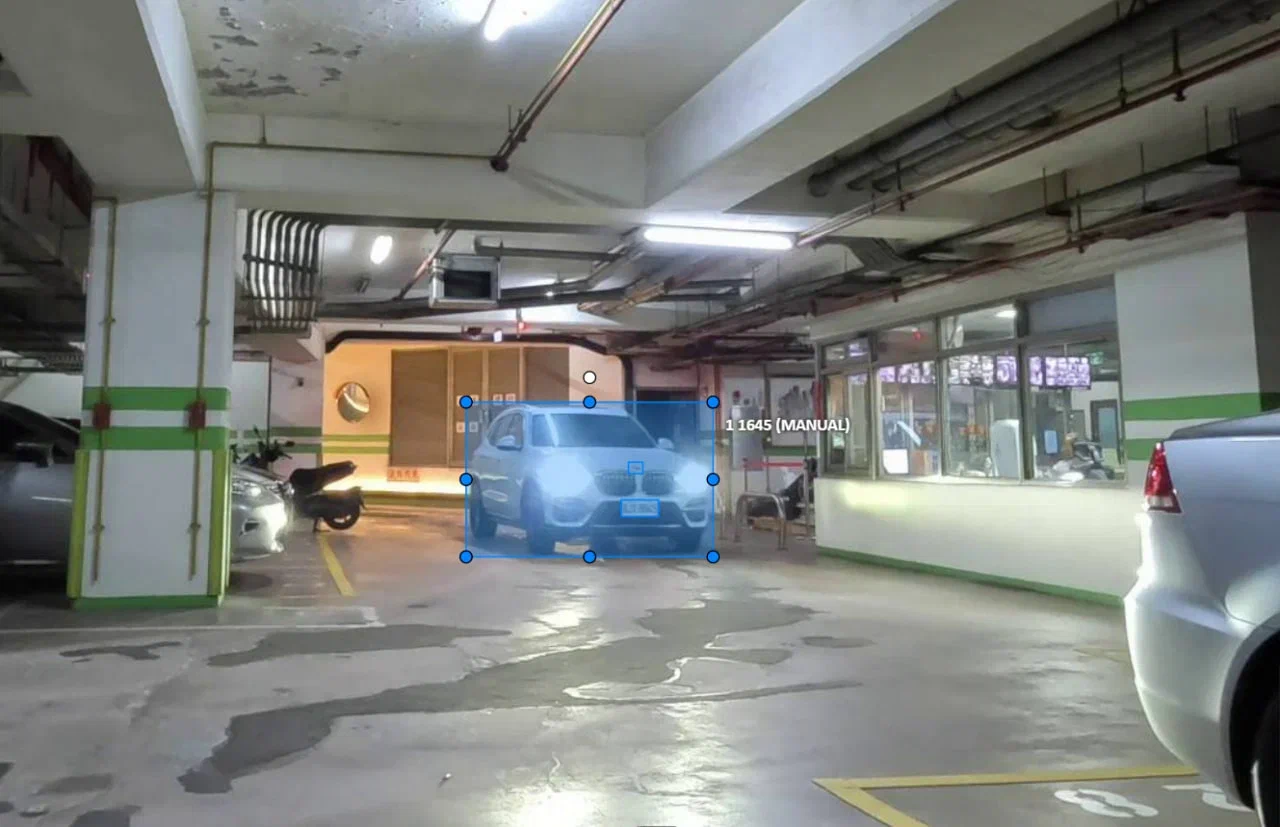
Распознавание автомобильных номеров традиционно считается одной из наиболее проработанных задач в области компьютерного зрения. Во многих странах такие системы успешно используются в дорожных камерах, системах контроля доступа и парковках. На первый взгляд может показаться, что достаточно взять готовую модель и применить её в новом проекте.
Однако на практике перенос таких решений между регионами оказывается существенно сложнее. Основная проблема заключается в том, что автомобильные номера не являются универсальным объектом. Их формат, структура и визуальное оформление сильно зависят от конкретной страны или даже региона.
Различия могут включать:
- использование разных алфавитов (латиница, арабская вязь, кириллица)
- различную структуру номера (последовательность букв и цифр, наличие символов)
- вариативность шрифтов и их читаемости
- размер и расположение элементов на номерной пластине
- дополнительные графические элементы (флаги, гербы, декоративные элементы)
Даже если визуально номера выглядят “похожими”, модель, обученная на одном наборе данных, не способна корректно обрабатывать другой формат. Это связано с тем, что модель не обладает абстрактным пониманием того, что такое автомобильный номер. Она извлекает статистические закономерности из обучающего набора и ожидает увидеть те же паттерны на новых данных.
При изменении этих паттернов — например, при переходе к другому языку или структуре номера — точность модели резко снижается. Ошибки могут проявляться как в детекции номера (модель не находит объект), так и в его распознавании (неправильно интерпретирует символы).
С точки зрения разметки данных задача также усложняется. Необходимо учитывать не только сам факт наличия номера, но и его структуру. Это может включать:
- выделение номерной области (detector)
- разметку символов (character-level annotation)
- учёт особенностей расположения текста
- обработку частично закрытых или загрязнённых номеров
Дополнительную сложность создают реальные условия эксплуатации. Номера могут быть сняты под разными углами, при плохом освещении, с низким качеством изображения или с частичными перекрытиями. Это требует расширения датасета за счёт разнообразных сценариев и повышения требований к качеству разметки.
В результате для достижения приемлемого уровня точности необходимо формирование нового датасета, адаптированного под конкретный регион. Это включает сбор данных, разработку гайдлайнов, разметку и последующее дообучение модели.
Вывод: даже задачи, которые считаются “решёнными” в рамках одного региона, требуют полной переадаптации при переносе в другой контекст. Универсальных моделей в таких случаях не существует, а ключевым фактором успеха становится качество и релевантность данных, на которых обучается система.
Кейс 3: Контроль качества пиццы
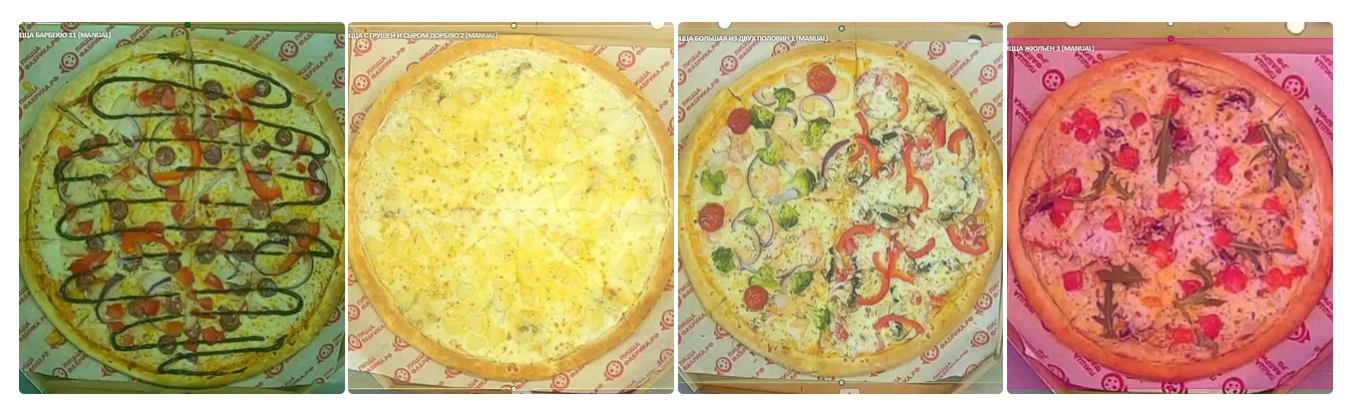
Задачи контроля качества продукции на практике оказываются значительно сложнее, чем может показаться на первый взгляд. Один из показательных примеров — контроль качества пиццы в сетевых заведениях общественного питания, где необходимо обеспечить единый стандарт приготовления во всех точках.
Формально задача может звучать просто: определить, соответствует ли пицца стандарту. Однако за этим стоит большое количество параметров, которые необходимо учитывать одновременно. К таким параметрам относятся состав ингредиентов, их наличие или отсутствие, правильность распределения по поверхности, соответствие рецептуре, степень прожарки, цвет теста, форма и даже корректность нарезки.
Дополнительную сложность создаёт масштаб. В рамках одной сети может существовать более 100 видов пицц, каждая из которых имеет уникальную рецептуру и правила приготовления. При этом многие ингредиенты визуально похожи друг на друга, могут частично перекрываться или изменять внешний вид после термической обработки. Это требует от системы не просто детекции объектов, а глубокого понимания контекста.
С точки зрения разметки данных задача становится многоуровневой. Необходимо одновременно размечать:
- наличие конкретных ингредиентов
- их расположение и плотность распределения
- визуальные характеристики (цвет, текстура, степень прожарки)
- соответствие итогового продукта эталонному изображению
При этом стандартные подходы к разметке, применяемые в универсальных датасетах, оказываются недостаточными. Требуется разработка детализированных гайдлайнов, описывающих не только “что размечать”, но и “как интерпретировать” сложные случаи. Например, как учитывать расплавленные ингредиенты, как оценивать равномерность распределения или как трактовать отклонения от рецептуры.
Организация процесса разметки в таких проектах также усложняется. Разметчики должны быть обучены предметной области и фактически выступать в роли экспертов, способных различать нюансы приготовления. Это требует дополнительного времени на обучение, внедрения многоуровневого контроля качества и постоянной калибровки команды.
Ещё одной проблемой является динамичность данных. Меню обновляется, рецептуры меняются, добавляются новые позиции. Это приводит к необходимости регулярного обновления датасета и повторного обучения модели, что делает процесс непрерывным.
В результате задача контроля качества пиццы выходит далеко за рамки классического компьютерного зрения и становится комплексной системой, включающей разметку, обучение, контроль качества и постоянную адаптацию к изменениям.
Вывод: задачи, связанные с оценкой качества продукции, практически невозможно решить с использованием готовых моделей или универсальных датасетов. Они требуют глубокой адаптации, сложной организации процесса разметки и тесной связи с бизнес-логикой. Чем ближе задача к реальным операционным процессам, тем выше требования к качеству данных и тем сложнее становится сама разметка.
Подходы к разметке
In-house
Полный контроль, но высокая стоимость и сложность управления.
Аутсорсинг
Гибкость и готовые процессы, но требует выстроенной коммуникации.
Краудсорсинг
Подходит для простых задач, но плохо масштабируется для сложных.
Синтетические данные
Синтетические данные позволяют генерировать большие объёмы информации и контролировать условия. Однако существует разрыв с реальными данными, что ограничивает их применение.
Организация процесса разметки
Эффективная разметка включает формализацию задачи, разработку гайдлайнов, обучение, пилот, контроль качества и масштабирование. Нарушение этого процесса приводит к снижению качества данных.
Заключение
Несмотря на развитие технологий, разметка данных остаётся ключевым фактором успеха ML-проектов. Качество данных определяет эффективность модели, а ошибки на этапе разметки трудно исправить на последующих стадиях.
Конкурентное преимущество формируется не только за счёт алгоритмов, но и за счёт качества данных.