
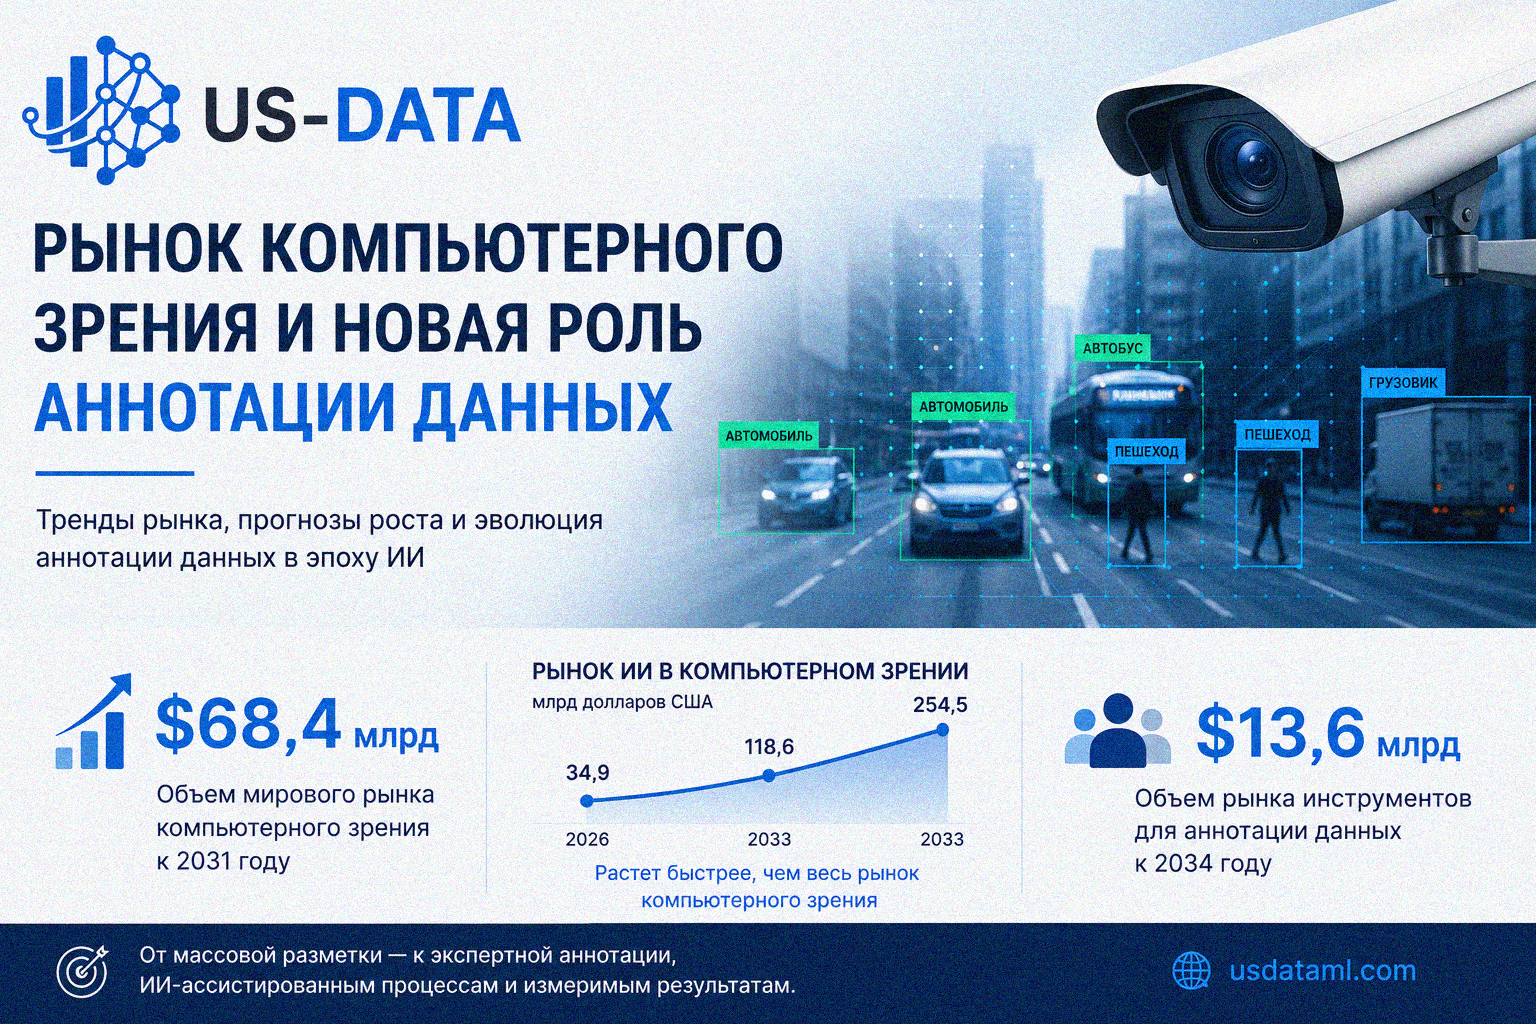
Мировой рынок компьютерного зрения продолжает активно развиваться. Компании все шире используют системы визуального анализа на базе искусственного интеллекта в промышленности, логистике, розничной торговле, здравоохранении, транспорте и сфере безопасности. Одновременно с этим растет и другой рынок — услуги и инструменты для разметки данных.
Несмотря на стремительное развитие foundation-моделей, автоматической разметки и готовых API компьютерного зрения, спрос на качественные размеченные данные остается высоким. На первый взгляд это может показаться парадоксом. Если современные модели уже умеют распознавать объекты, сцены и паттерны без длительной настройки, зачем компаниям продолжать инвестировать в разметку?
Ответ заключается в изменении самой роли разметки данных. Она не исчезает — меняется ее место в жизненном цикле машинного обучения.
Рутинные задачи разметки все чаще автоматизируются с помощью предварительной разметки, синтетических данных и AI-ассистированных процессов. При этом возрастает ценность человеческой экспертизы там, где качество данных напрямую влияет на точность модели, безопасность системы и конечные бизнес-результаты. Поэтому рынок постепенно смещается от модели «больше разметки за меньшие деньги» к модели «лучшие данные для лучших результатов».
Рост рынка продолжается, несмотря на различия в прогнозах
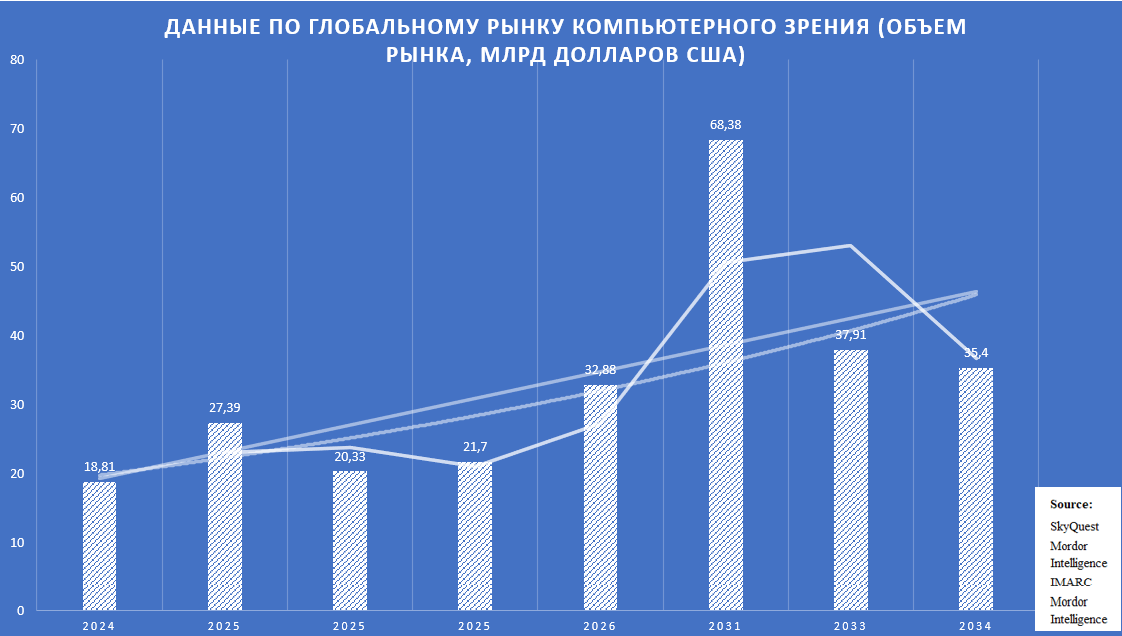
Прогнозы мирового рынка компьютерного зрения (2024–2034)
Большинство аналитиков сходятся во мнении, что компьютерное зрение остается одним из самых быстрорастущих сегментов ИИ-экономики. Конкретные оценки рынка различаются в зависимости от методологии исследования и того, какие технологии включаются в расчеты, однако общий тренд остается неизменным.
Компании продолжают инвестировать в решения, позволяющие машинам анализировать и интерпретировать визуальную информацию. Основными драйверами роста остаются промышленная автоматизация, интеллектуальное видеонаблюдение, аналитика в ритейле, транспортные системы, робототехника и контроль качества продукции.
По мере того как технологии компьютерного зрения становятся частью повседневных бизнес-процессов, растет спрос не только на программные платформы, но и на инфраструктуру данных, необходимую для их обучения и поддержки.
Хотя оценки объема рынка различаются, общий вывод остается одинаковым: компьютерное зрение постепенно переходит от экспериментальных проектов к массовому промышленному использованию. Это формирует новые требования к качеству данных, непрерывному обучению моделей и контролю качества.
Рынок ИИ в компьютерном зрении растет еще быстрее
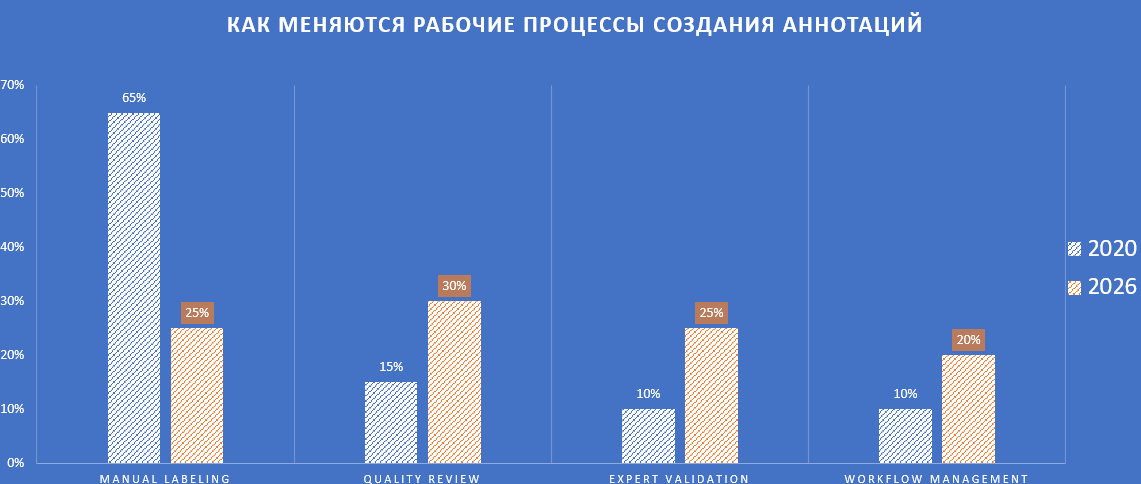
Особенно высокие темпы роста демонстрирует сегмент, который аналитики обозначают как «AI in Computer Vision». В него входят современные системы восприятия, объединяющие компьютерное зрение, генеративный ИИ, мультимодальные модели и автоматизированное принятие решений.
Согласно большинству прогнозов, в ближайшее десятилетие этот сегмент будет расти значительно быстрее классического рынка компьютерного зрения.
Причина проста: бизнесу все чаще нужны не отдельные инструменты распознавания изображений, а полноценные интеллектуальные системы, способные анализировать данные и помогать принимать решения.
По мере расширения внедрения ИИ компании сталкиваются с новой задачей. Недостаточно просто обучить модель. Необходимо поддерживать качество данных, обновлять датасеты, отслеживать деградацию моделей и устранять ошибки, возникающие в реальной эксплуатации.
Именно эта растущая сложность создает дополнительный спрос на профессиональную разметку данных и управление жизненным циклом датасетов.
Парадокс рынка разметки данных
На рынке разметки данных наблюдается интересная ситуация.
С одной стороны, автоматизация сокращает объем ручного труда, необходимого для выполнения многих задач. С другой стороны, расходы компаний на разметку продолжают увеличиваться.
На самом деле эти процессы не противоречат друг другу.
Современные проекты все чаще используют предварительную разметку, созданную нейросетями. Затем результаты проверяются и корректируются специалистами. Такой подход позволяет значительно ускорить обработку типовых данных.
Одновременно компании начинают больше инвестировать в контроль качества, работу с пограничными случаями, экспертную валидацию и построение устойчивых процессов управления данными.
В результате ценность разметки все меньше определяется количеством размеченных объектов и все больше — способностью обеспечить соответствие данных реальным условиям эксплуатации моделей.
Поэтому рынок постепенно трансформируется из сферы массового ручного труда в область управляемых сервисов, сочетающих автоматизацию, экспертизу и контроль качества.
Исследования рынка подтверждают эту тенденцию. Большинство аналитиков ожидают долгосрочный рост сегмента инструментов и сервисов разметки данных. При этом быстрее всего растет направление managed services — комплексных услуг по сопровождению процессов подготовки данных.
Это говорит о том, что компании ищут не просто программные инструменты, а партнеров, способных встроиться в процесс разработки и развития ИИ-систем.
Почему «простая» разметка теряет ценность
На протяжении многих лет экономика рынка разметки строилась по относительно простой модели. Компании собирали большие объемы данных, привлекали команды разметчиков и масштабировали проекты за счет увеличения количества специалистов.
Сегодня эта модель испытывает серьезное давление.
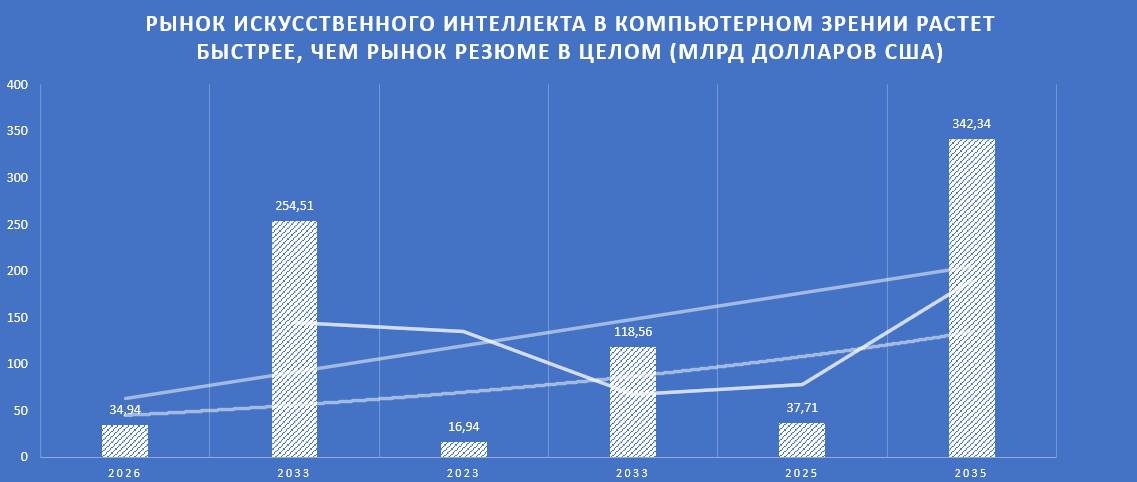
Одной из причин стало распространение AI-assisted annotation. Во многих проектах данные сначала размечаются автоматически, а затем проверяются людьми. Вместо создания разметки с нуля специалисты все чаще занимаются верификацией, корректировкой и контролем качества.
Схожее влияние оказывают синтетические данные. В автомобильной отрасли, робототехнике и промышленной автоматизации компании активно используют виртуальные среды для генерации обучающих датасетов. Такие данные часто создаются уже вместе с аннотациями, что снижает потребность в ручной разметке.
Дополнительным фактором становится развитие крупных предобученных моделей. Сегодня для многих типовых задач можно использовать уже готовые решения, способные распознавать людей, автомобили, документы, товары и другие распространенные объекты.
Все эти изменения постепенно превращают разметку из трудоемкого массового процесса в более специализированную функцию.
При этом автоматизация сокращает потребность в базовой разметке, но одновременно увеличивает спрос на экспертизу в области контроля качества, валидации данных и работы со сложными случаями.
Почему экспертная разметка становится более востребованной
Снижение ценности рутинной разметки вовсе не означает, что сама разметка становится менее важной. Во многих случаях происходит обратное.
По мере того как системы компьютерного зрения переходят из лабораторий в реальные производственные процессы, качество их работы все сильнее зависит от способности корректно обрабатывать нестандартные и редкие ситуации.
Именно такие случаи зачастую становятся причиной ошибок моделей, несмотря на то что в обучающей выборке они занимают лишь небольшую долю данных.
Например, беспилотный автомобиль может безошибочно распознавать тысячи стандартных дорожных сцен, но испытывать трудности при сильном снегопаде, плохом освещении, поврежденных дорожных знаках или появлении неожиданных препятствий на дороге.
Похожая ситуация наблюдается в медицине. Модель может уверенно работать с распространенными случаями, но сталкиваться с проблемами при диагностике редких патологий или спорных клинических ситуаций.
В промышленности сложность часто заключается не в обнаружении объекта как такового, а в определении степени критичности дефекта, его классификации и оценке влияния на качество продукции.
Поэтому компании все чаще уделяют внимание не скорости разметки, а качеству аннотаций, их согласованности, воспроизводимости и экспертной проверке.
Сам процесс подготовки данных становится значительно сложнее. Многие проекты включают пилотные этапы, перекрестную проверку аннотаций, измерение согласованности между разметчиками, процедуры эскалации спорных случаев и постоянное взаимодействие между командами разметки и ML-инженерами.
Фактически заказчики платят уже не просто за разметку. Они платят за уверенность в том, что данные корректно отражают реальность и позволяют обучить надежную модель.
Разметка становится частью MLOps
Еще одно важное изменение связано не столько с технологиями, сколько с организацией процессов.
Раньше разметка часто воспринималась как разовая задача, которую необходимо выполнить перед обучением модели. После подготовки датасета основное внимание переключалось на разработку и внедрение системы.
Сегодня такой подход постепенно уходит в прошлое.
После запуска модели начинают получать новые данные, сталкиваются с новыми сценариями использования и изменяющейся средой. Появляются новые типы объектов, меняется поведение пользователей, возникают ситуации, которые отсутствовали в исходном датасете.
В результате данные требуют постоянного обновления и поддержки.
Именно поэтому многие компании начинают рассматривать разметку как полноценную часть MLOps-процессов. Датасеты получают версии, отслеживаются показатели качества, а данные из production-среды регулярно используются для дообучения моделей.
В такой модели разметка становится непрерывным процессом. Команды не только создают аннотации, но и поддерживают правила разметки, анализируют ошибки моделей, выявляют пробелы в данных и участвуют в циклах улучшения качества.
Для зрелых AI-команд разметка постепенно превращается в связующее звено между сбором данных, обучением моделей, внедрением и контролем качества.
Это меняет и источники конкурентного преимущества. Сегодня важно не просто иметь большой датасет, а обладать процессом, позволяющим постоянно улучшать его вместе с моделью.
Регулирование повышает требования к качеству данных
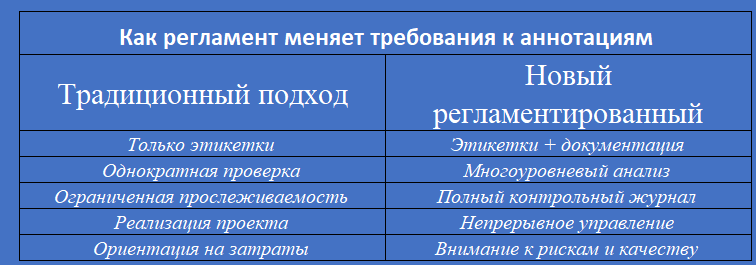
На рынок разметки влияют не только технологии. Все большую роль начинают играть требования регуляторов.
Особенно это касается сфер, где системы искусственного интеллекта могут влиять на безопасность людей, медицинские решения, транспортную инфраструктуру, трудоустройство или другие чувствительные области.
Одним из ключевых событий последних лет стало принятие европейского закона EU AI Act.
Документ вводит требования к прозрачности, управлению рисками, документированию и человеческому контролю над высокорисковыми ИИ-системами.
Даже если конкретный проект не относится к категории высокорисковых, общий вектор развития рынка становится очевидным. От компаний все чаще требуется не только демонстрировать высокую точность моделей, но и объяснять, каким образом эти модели создавались, обучались и контролируются.
Для рынка разметки это означает существенные изменения.
Если раньше подготовка данных воспринималась как внутренний технический процесс, то теперь все большее значение приобретают документирование процедур, отслеживаемость изменений и прозрачность принятия решений.
Организации должны понимать:
- кто выполнял разметку;
- какие инструкции использовались;
- какие проверки качества проводились;
- каким образом разрешались спорные случаи.
В результате такие характеристики, как аудируемость, воспроизводимость и прозрачность процессов, становятся не менее важными, чем точность аннотаций.
Для поставщиков услуг это открывает новые возможности. Компании, способные предложить структурированные процессы контроля качества и прозрачные механизмы управления данными, получают дополнительные конкурентные преимущества по сравнению с игроками, конкурирующими исключительно за счет стоимости работ.
По сути, регулирование ускоряет уже существующую тенденцию: разметка данных становится частью системы управления ИИ, а не отдельной операционной задачей.
Россия остается растущим рынком компьютерного зрения
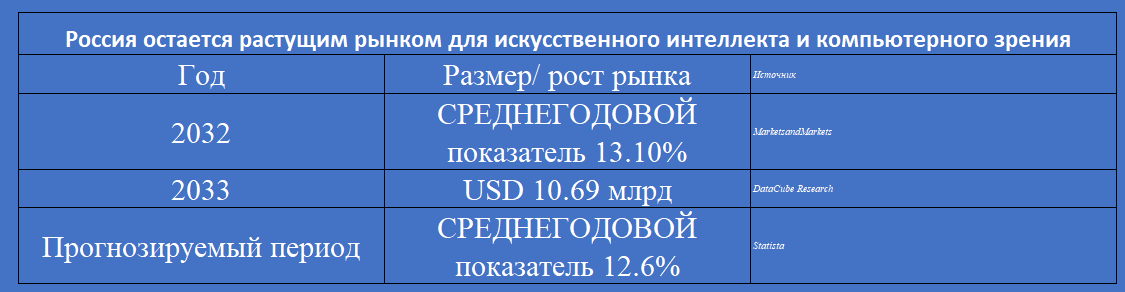
Хотя основное внимание в мировой AI-индустрии традиционно сосредоточено на США, Европе и Китае, российский рынок компьютерного зрения также демонстрирует устойчивый рост.
Согласно прогнозам аналитиков, спрос продолжает увеличиваться в сегментах видеонаблюдения, промышленной автоматизации, логистики, проектов «умного города» и производственного контроля.
Наиболее крупным направлением остается безопасность, однако все больше инвестиций направляется в системы контроля качества продукции, предиктивного обслуживания оборудования и автоматизации производственных процессов.
Росту рынка способствует сразу несколько факторов.
С одной стороны, компании стремятся повысить эффективность операций за счет автоматизации. С другой — возрастает интерес к локальной инфраструктуре и собственным технологическим решениям.
В таких условиях особую роль начинают играть локальные датасеты и процессы подготовки данных, адаптированные под конкретные условия эксплуатации.
Для поставщиков услуг разметки это означает дополнительные возможности. Многие проекты требуют не просто перевода существующих решений на российский рынок, а глубокой адаптации данных, правил классификации и методик аннотирования под местную специфику.
В более широком смысле ситуация в России отражает общемировую тенденцию: по мере роста внедрения ИИ увеличивается и спрос на специализированные сервисы подготовки данных.
Свежие сигналы рынка
События последних лет позволяют лучше понять направление развития рынка компьютерного зрения и разметки данных.
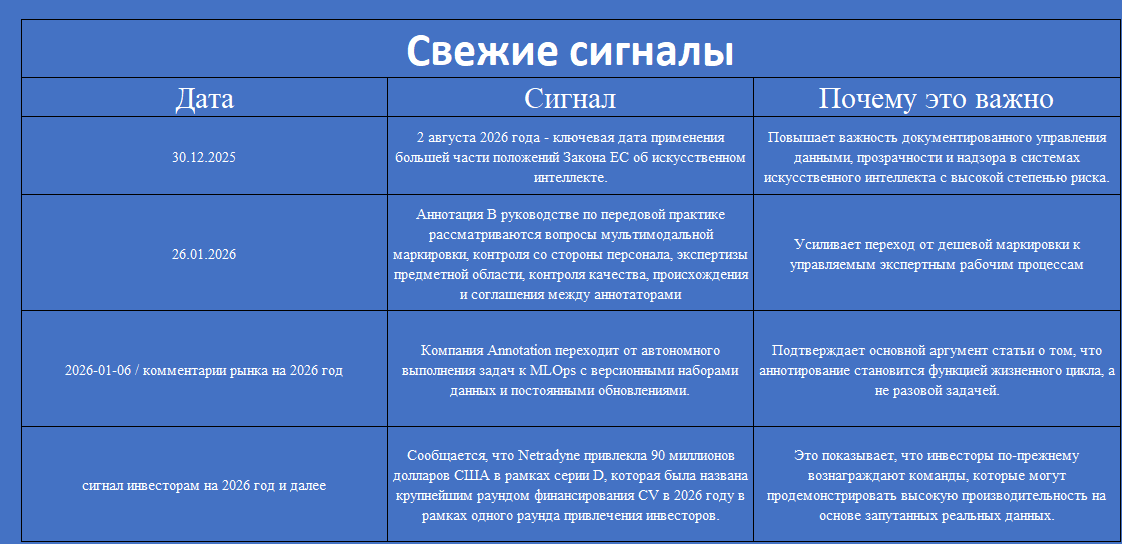
Во-первых, приближение ключевых этапов внедрения требований EU AI Act заставляет компании пересматривать подходы к разработке и эксплуатации систем искусственного интеллекта. Вопросы человеческого контроля, прозрачности алгоритмов и документирования процессов постепенно переходят из категории рекомендаций в категорию обязательных требований.
Во-вторых, заметно изменился характер дискуссий внутри самой отрасли.
Еще несколько лет назад основное внимание уделялось масштабированию процессов разметки: сколько изображений можно обработать, как сократить стоимость работ и ускорить подготовку датасетов.
Сегодня в центре внимания находятся другие вопросы:
- покрытие редких и сложных сценариев;
- качество аннотаций;
- контроль ошибок;
- интеграция разметки в процессы MLOps;
- обеспечение надежности моделей в production-среде.
Это говорит о взрослении рынка и переходе от количественных показателей к качественным.
В-третьих, интерес инвесторов к компаниям, работающим в области компьютерного зрения, остается высоким. Однако инвесторы все чаще оценивают не только технологические возможности решений, но и их способность демонстрировать устойчивые результаты в реальных условиях эксплуатации.
Практика показывает, что успешность проекта зависит не столько от архитектуры модели, сколько от качества данных, на которых она обучается, и способности поддерживать это качество на протяжении всего жизненного цикла системы.
Все эти факторы указывают на то, что рынок вступает в новую стадию развития. Рост остается высоким, однако конкурентные преимущества все чаще формируются не за счет доступа к технологиям как таковым, а благодаря качеству процессов и уровню экспертизы.
Что это означает для поставщиков услуг
Для компаний, работающих в сфере подготовки данных и разметки, происходящие изменения имеют вполне конкретные последствия.
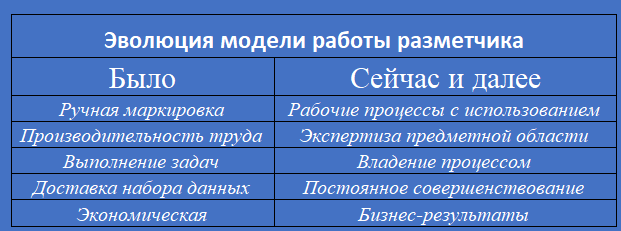
Традиционная модель бизнеса, основанная на большом объеме недорогой ручной разметки, постепенно сталкивается с растущим давлением со стороны автоматизации.
Предварительная разметка, foundation-модели и синтетические данные позволяют существенно сократить объем рутинной работы, ранее выполнявшейся людьми.
Однако это не означает сокращение спроса на услуги в целом.
Наоборот, ценность смещается в сторону более сложных и интеллектуальных задач.
Сегодня заказчикам все чаще требуются партнеры, способные:
- проектировать схемы разметки;
- разрабатывать инструкции и гайдлайны;
- выстраивать процессы контроля качества;
- организовывать экспертную проверку данных;
- работать со сложными и неоднозначными случаями;
- поддерживать циклы непрерывного улучшения моделей.
Именно эти задачи сложнее всего автоматизировать.
Поэтому наиболее сильные игроки рынка постепенно перестают быть просто поставщиками трудовых ресурсов и превращаются в полноценную часть инфраструктуры разработки искусственного интеллекта.
Подобная трансформация уже происходила в других технологических отраслях. По мере развития инструментов основным фактором конкурентоспособности становится не сам инструмент, а качество его применения.
Рынок разметки данных движется в том же направлении.
Заключение
Рынок компьютерного зрения продолжает расти, а вместе с ним развивается и рынок разметки данных.
Главное изменение заключается не в снижении потребности в аннотациях, а в трансформации самой ценности разметки.
Рутинные задачи все чаще автоматизируются с помощью AI-ассистированных инструментов, предварительной разметки и синтетических данных. Одновременно возрастает значимость экспертной проверки, контроля качества, управления данными и интеграции процессов подготовки данных в жизненный цикл моделей.
Эта тенденция отражает общий процесс взросления индустрии искусственного интеллекта.
По мере перехода компаний от пилотных проектов к промышленному внедрению ключевым фактором успеха становится уже не объем данных как таковой, а их качество, актуальность и способность отражать реальные условия эксплуатации.
Для бизнеса главный вопрос сегодня звучит не как «нужна ли разметка данных?».
Гораздо важнее понять, какие этапы подготовки данных можно автоматизировать, а какие по-прежнему требуют участия специалистов, отраслевой экспертизы и выстроенных процессов контроля качества.
Именно ответ на этот вопрос будет определять эффективность следующего поколения систем компьютерного зрения.
Скачать исследование (PDF)
Источники и методология
При подготовке материала использовались данные и прогнозы ведущих аналитических агентств, исследовательских компаний и отраслевых публикаций.