
1. Почему разметка данных — это не “посадить людей рисовать боксы”
В современных проектах машинного обучения и компьютерного зрения качество данных становится определяющим фактором эффективности модели. Несмотря на развитие архитектур и появление предобученных решений, именно данные — а точнее, их корректная интерпретация через разметку — формируют основу для обучения алгоритмов.
Разметка данных представляет собой процесс преобразования «сырых» данных (изображений, видео, текста) в структурированный формат, пригодный для обучения моделей. В задачах компьютерного зрения это, как правило, включает:
- локализацию объектов (bounding boxes)
- сегментацию
- определение ключевых точек (keypoints)
- классификацию
С теоретической точки зрения разметка выполняет роль обучающего сигнала (ground truth), на основании которого модель формирует внутренние зависимости. Ошибки или неоднородность в этом сигнале напрямую влияют на способность модели к обобщению и точности предсказаний.
Разметка как производственный процесс
На практике разметка данных часто воспринимается как простая операционная задача. Распространённый сценарий — выделить команду аннотаторов и поручить им «разметить датасет». Однако такой подход игнорирует системную природу процесса.
Корректнее рассматривать разметку как производственный цикл, включающий несколько взаимосвязанных этапов:
- формализацию задачи и определение требований к данным
- разработку инструкций (guidelines)
- настройку инструментальной среды
- обучение и координацию команды
- контроль качества
- подготовку данных к интеграции в ML-пайплайн
Каждый из этих этапов влияет на итоговое качество датасета. Отсутствие стандартизации или слабый контроль на любом уровне приводит к накоплению ошибок, которые становятся заметны уже на этапе обучения модели.
Проблема неоднородности разметки
Одной из ключевых теоретических проблем является консистентность аннотаций. Даже при наличии формально одинаковой задачи разные исполнители могут интерпретировать её по-разному.
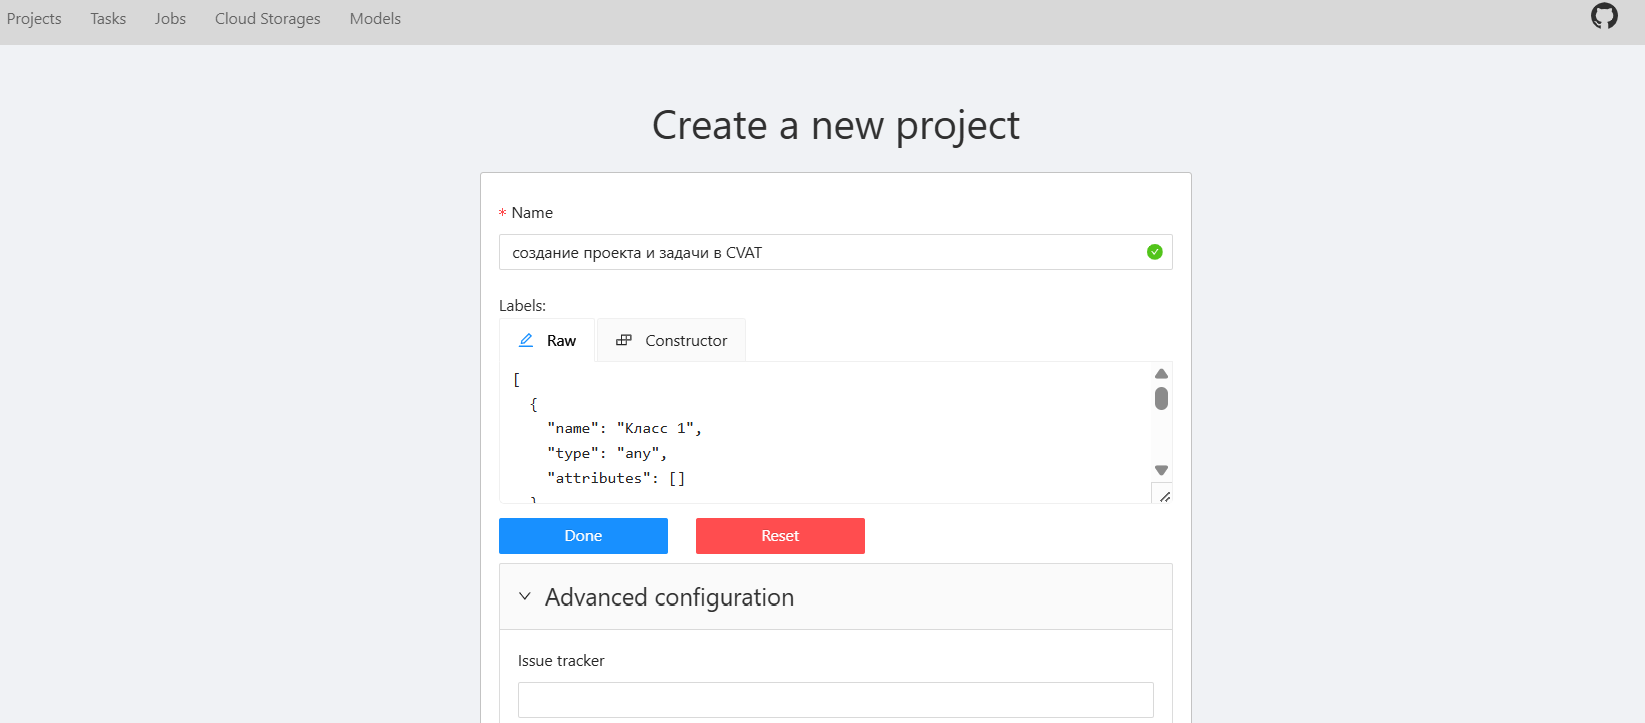
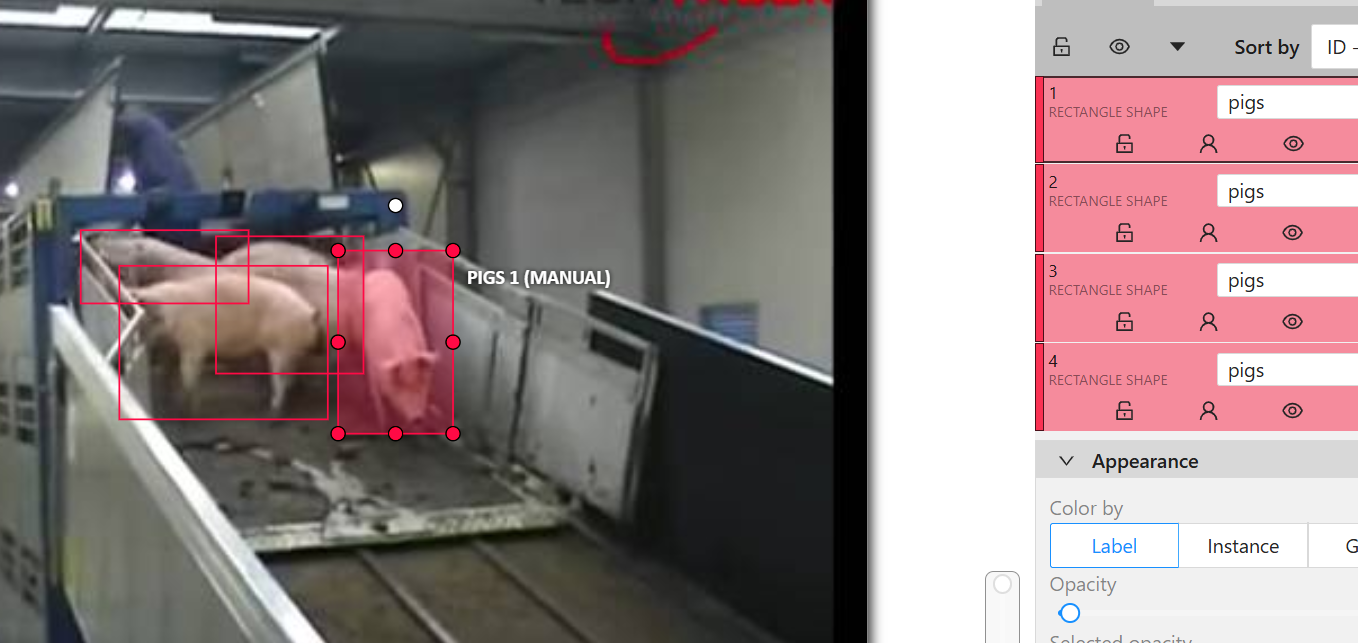
Рассмотрим типичный пример задачи детекции людей на изображениях. Без чётко заданных правил аннотаторы могут:
- включать в bounding box разные части тела
- по-разному обрабатывать частично перекрытые объекты
- игнорировать мелкие или размытые объекты
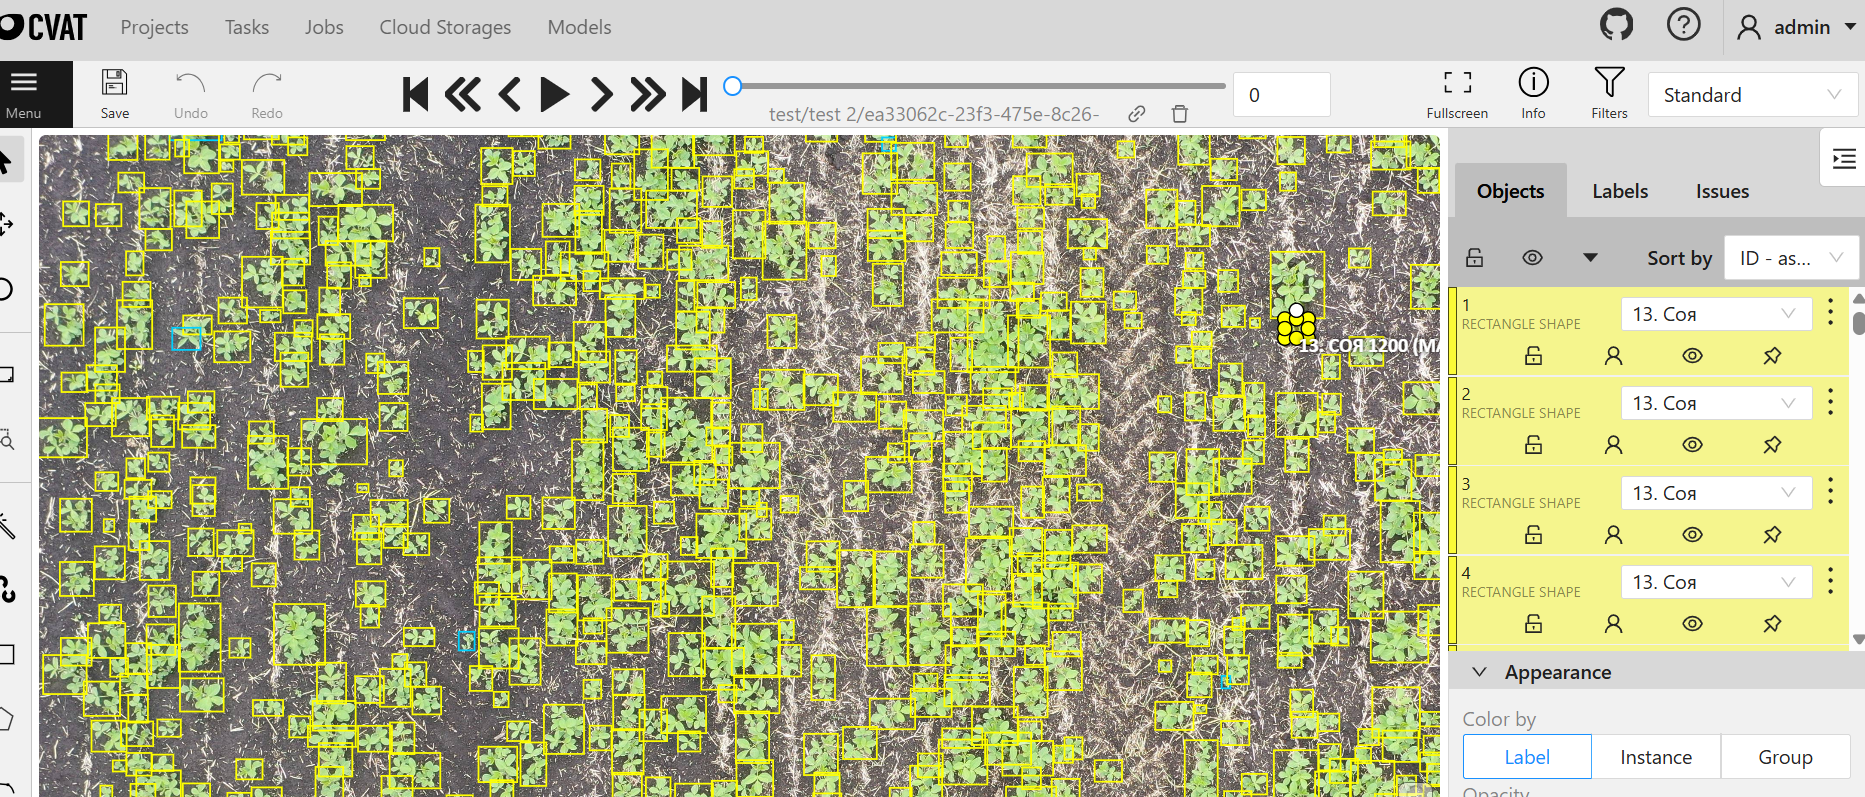
В результате формируется неоднородный датасет, в котором один и тот же класс представлен различными по структуре аннотациями. Для модели это означает отсутствие стабильного обучающего сигнала, что приводит к снижению качества предсказаний.
Роль инструмента: возможности и ограничения
CVAT является одним из наиболее распространённых инструментов для разметки данных в задачах компьютерного зрения. Он предоставляет интерфейс для аннотации изображений и видео, поддержку различных типов разметки, систему ролей пользователей и базовые механизмы контроля качества.
Однако важно понимать, что инструмент сам по себе не решает организационных задач. CVAT не определяет правила разметки, не обеспечивает единообразие аннотаций и не гарантирует качество данных без соответствующей методологии и контроля.
Практическое проявление сложности
Внешне процесс разметки может выглядеть линейным, однако за этой последовательностью скрывается множество управленческих решений: от структуры задач до контроля качества и масштабирования.
ИТОГ: разметка данных — это ключевой элемент ML-систем, требующий системного подхода и управляемой инфраструктуры.
2. Архитектура процесса разметки: как это устроено на практике
Разметка данных представляет собой не линейную цепочку действий, а управляемый производственный цикл. Ключевая особенность — итеративность: данные возвращаются на предыдущие этапы, инструкции уточняются, а ошибки исправляются.
Подготовка данных
Сырые данные содержат шум: дубликаты, брак, нерелевантный контент. Без предварительной обработки это приводит к снижению качества и перегрузке команды.
Формализация задачи
Инструкции (guidelines) определяют, как именно интерпретировать данные. Без них возникает расхождение в разметке, которое невозможно исправить без переразметки.
Разметка как поток задач
Структура Project → Task → Job:
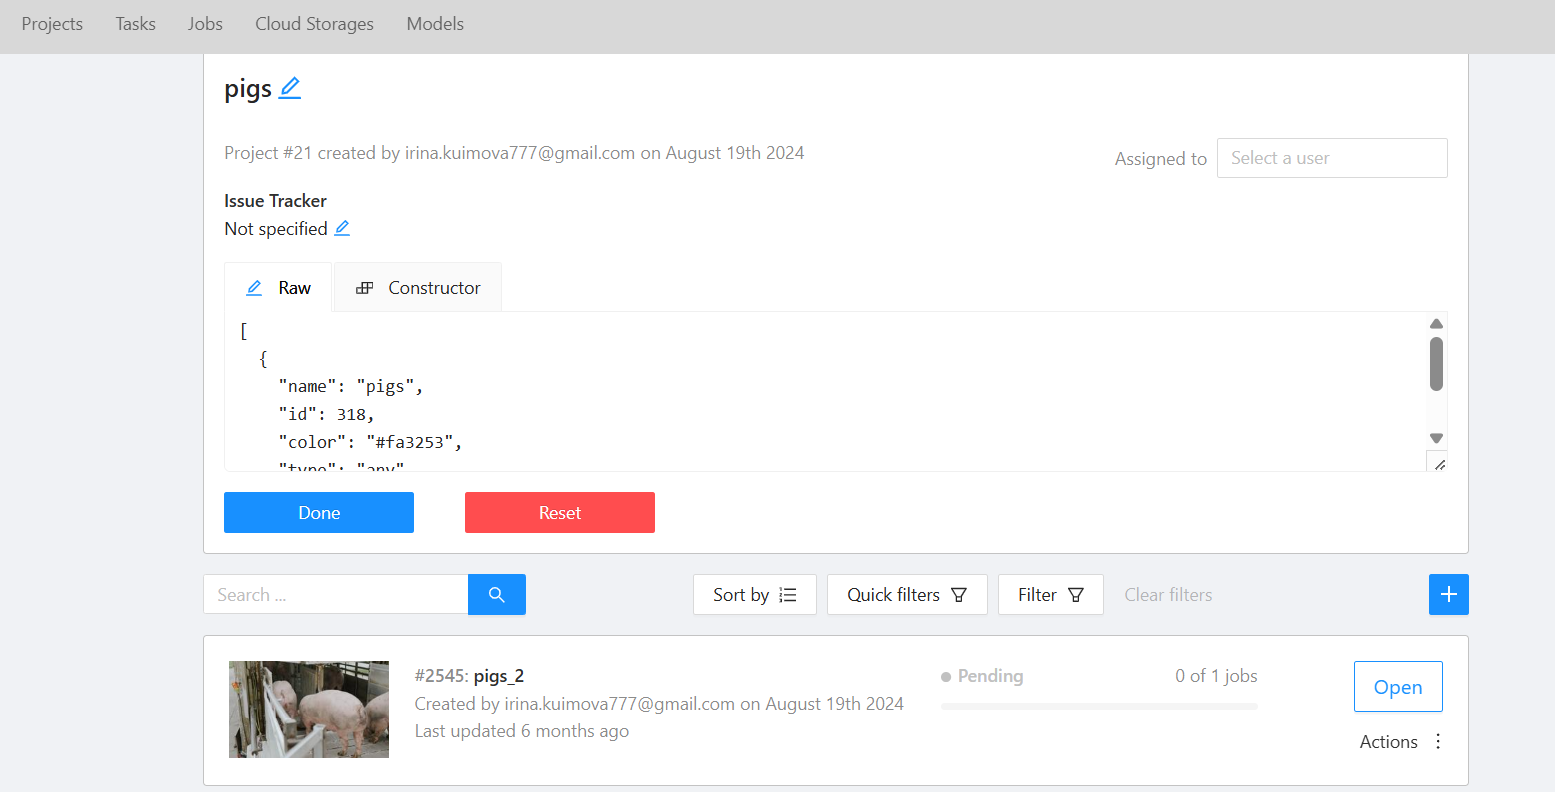
Задачи должны быть сбалансированы: слишком большие замедляют работу, слишком маленькие увеличивают административные расходы.
Контроль качества
Контроль качества встроен в процесс и выполняется непрерывно через ревью и возврат задач.
Экспорт и цикл обучения
После обучения модели выявляются ошибки в данных, которые возвращаются в процесс разметки.
ИТОГ: разметка — это циклическая система с постоянной обратной связью.
3. Техническая инфраструктура: сервер, развёртывание и доступ
Инфраструктура определяет стабильность всей системы разметки. CVAT — это многокомпонентное приложение, требующее ресурсов и настройки.
Требования к серверу
- 4–8 vCPU
- 16–32 GB RAM
- SSD (NVMe)
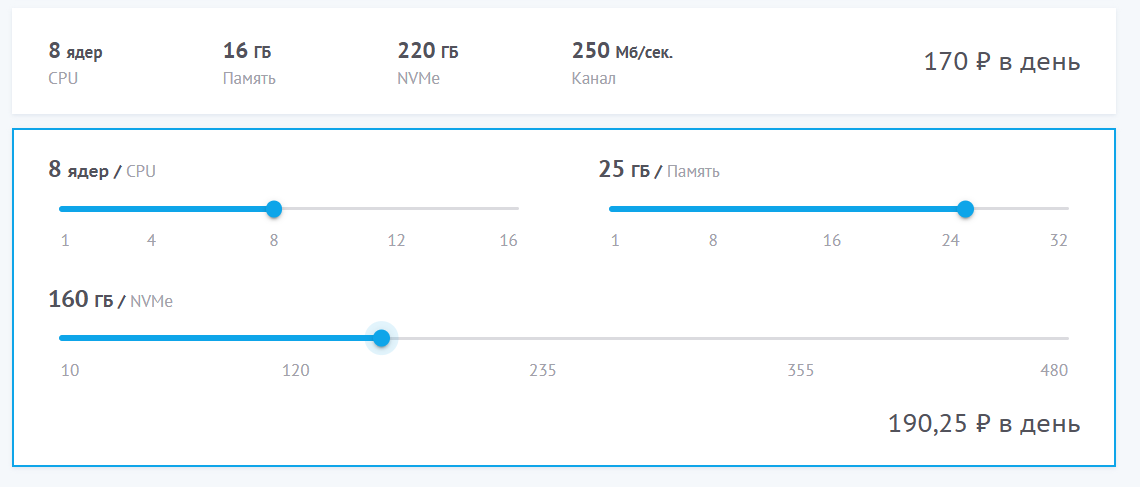
При росте команды требования увеличиваются, особенно по оперативной памяти.
Облако vs свой сервер
Облако даёт быстрый старт и масштабирование, но увеличивает расходы. Своя инфраструктура требует компетенций и поддержки.
Развёртывание CVAT
git clone https://github.com/opencv/cvat
cd cvat
docker compose up -d
Поднимаются backend, frontend, PostgreSQL и Redis. При нехватке ресурсов возможны падения контейнеров.
Настройка домена и HTTPS
server {
    server_name cvat.yourdomain.com;

    location / {
        proxy_pass http://localhost:8080;
    }

    listen 443 ssl;
    ssl_certificate /etc/letsencrypt/live/cvat/fullchain.pem;
    ssl_certificate_key /etc/letsencrypt/live/cvat/privkey.pem;
}
certbot --nginx -d cvat.yourdomain.comПользователи и роли
Управление пользователями в CVAT:
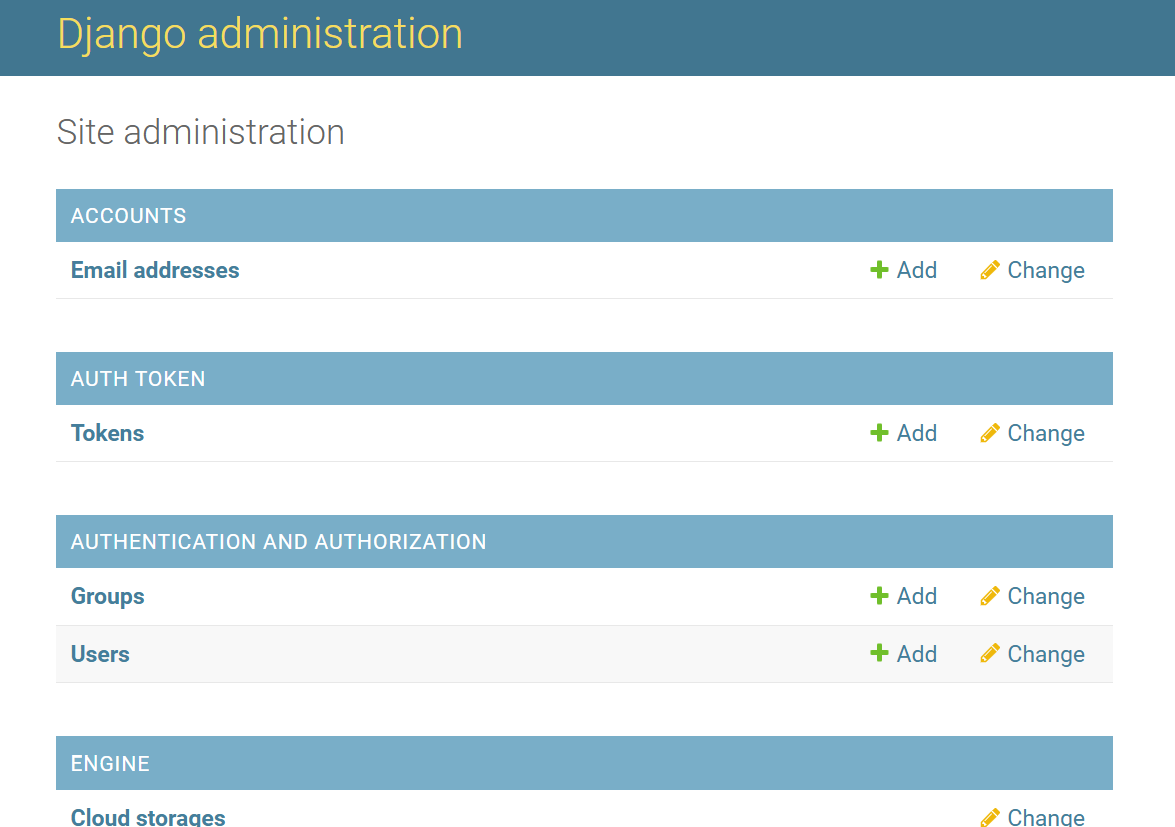
- администраторы
- аннотаторы
- ревьюеры
Типичные проблемы
- падение производительности
- нагрузка на диск и сеть
- сложности с обновлениями
- необходимость бэкапов
ИТОГ: инфраструктура — это отдельная зона ответственности, требующая экспертизы.
12. Заключение: разметка как система, а не инструмент
Организация разметки данных в CVAT оказывается значительно сложнее, чем это выглядит на старте. За простым интерфейсом скрывается многоуровневая система, в которой каждая ошибка масштабируется вместе с объёмом данных.
Разметка требует:
- устойчивой инфраструктуры
- формализованных правил
- обученной команды
- контроля качества
- итеративного подхода
Практика показывает, что при масштабировании in-house процессов возникают проблемы с качеством, управлением и инфраструктурой.
Таким образом, выбор между самостоятельной разметкой и привлечением внешних исполнителей — это вопрос управления сложностью, а не только бюджета.
Разметка данных — это фундамент модели, и именно его качество определяет итоговый результат.